딥러닝의 수학 | Scientific Theory of Deep Learning
📐 딥러닝의 과학적 이론과 학습 역학(Learning Mechanics)을 소개합니다.
KEYWORDS
Learning Mechanics, Scientific Theory of Deep Learning, Deep Linear Networks, Neural Tangent Kernel, Neural Scaling Laws, Edge of Stability, Maximal Update Parametrization, 딥러닝 이론, 딥러닝 수학, 딥러닝 논문 리뷰
Original Paper | There Will Be a Scientific Theory of Deep Learning
Introduction
- 현재의 딥러닝은 잘 작동합니다. 그런데 왜 잘 작동하는지는 아직 정확히 모릅니다.
- 신경망을 어떻게 설계하고 학습하는지에 대한 노하우는 쌓였지만, 이는 대부분 시행착오(Trial and Error) 로 발견된 것입니다.
- 이론은 일상적인 실무에 거의 영향을 주지 못하고, LLM과 Diffusion Model의 시대에 들어서면서 수수께끼는 오히려 더 깊어졌습니다.
- 특히 Nonconvex 손실 지형과 Overparameterized 모델이 어떻게 그렇게 잘 일반화되는지는, 고전의 머신러닝 이론이 설명할 수 있는 범위를 넘어섭니다.
- 성능 개선이라는 당장의 목표를 잠시 내려놓고 기초 이해를 추구하는 것이 장기적으로 더 큰 성능 향상을 가져온다는 관점이 있습니다 1.
- 증기기관이 먼저 개발되고 그 뒤에 열역학이 뒤따라 왔듯, 공학적 성공은 종종 과학에 대해 선행합니다.
- 핵발전은 과거의 발전소를 반복 개선해서 얻어진 것이 아니라, 아원자 입자 이론이라는 우회로를 거쳐 나왔습니다.
- 그럼에도 딥러닝의 과학적 이론이 가능하다는 관점이 점차 뚜렷해지고 있으며, 그 조짐이 다섯 가지 연구 흐름으로 드러나고 있습니다 2.
- Solvable Settings ㅣ 분석적으로 풀리는 이상화된 설정
- Insightful Limits ㅣ 통찰을 주는 극한
- Simple Empirical Laws ㅣ 거시적 통계를 포착하는 단순 경험 법칙
- Hyperparameter Theories ㅣ 하이퍼파라미터를 분리·이해하는 이론
- Universal Phenomena ㅣ 시스템과 설정을 가로지르는 보편 현상
- 이 다섯 흐름은 공통적으로 학습 과정의 동역학을 다루고, 거시적 집계 통계를 서술하며, 반증 가능한 정량 예측을 추구합니다.
- 이러한 특성은 고전역학·연속체역학·통계역학·양자역학의 전형과 닮아 있어, 이 과학은 학습 역학(Learning Mechanics) 이라는 이름으로 불릴 수 있습니다.
- 아래에서는 다섯 증거를 순서대로 살펴본 뒤, 학습 역학의 성격과 다른 관점들과의 관계를 서술합니다.
왜 수학이 필요한가?
- 과거의 기계 학습 이론은 표현력(Expressivity) 과 일반화(Generalization) 를 주로 다뤘고, 고전 학습 이론(Classical Learning Theory), PAC 학습 이론, 그리고 통계물리 기반 평균 사례(Average-case) 분석이 그 기반이었습니다.
- 하지만 딥러닝은 Nonconvex · Overparameterized 되어 있고, 고전 이론이 보장하거나 설명할 수 있는 수준보다 더 잘 최적화되고 일반화됩니다.
- 신경망은 단순히 데이터를 맞추는 것이 아니라 구조화된 내부 표현(Representation) 을 학습하고, Task와 Scale에 걸쳐 뚜렷한 규칙성을 보입니다.
이러한 상황은 고전 이론의 수학적 증명에서 벗어나, 실제 시스템을 서술하고 설명하고 예측하는 과학으로 넘어가는 성격의 전환을 보여줍니다.
- 이 전환을 성공적으로 해내려면 과학을 어떻게 수행할 것인지에 대한 메타 관점이 필요합니다.
- 첫째, 어떤 미지의 대상을 체계적으로 탐색할 때 과학의 본질은 두 단계로 정리됩니다 3.
- 단계 A ㅣ 무언가를 알아낸다
- 단계 B ㅣ 틀리지 않았는지 확인한다
- 두 단계 중 하나만 하면 철학이거나 공학이 되고, 두 단계를 모두 해야 과학이 성립합니다.
- 딥러닝은 실험 비용이 낮고 측정 가능성이 높아, 두 단계를 빠른 반복 루프로 결합하기에 적합한 분야입니다.
- 둘째, 이 탐색을 지형과 지도의 비유로 보면 다음과 같이 정리됩니다 4.
- 과제 구조, 모델 아키텍처, 옵티마이저 설계, 하이퍼파라미터 선택이 지형의 좌표를 이룹니다.
- 과학적 결과는 이 지형의 지도(Map) 를 만드는 작업이며, 정리·계산·법칙·휴리스틱·실증 어느 것이든 유용한 지도가 될 수 있습니다.
- 학습 역학의 목표는 산발적 현장 가이드(Field Guide) 를 통합된 지도 로 바꾸는 것입니다.
- 첫째, 어떤 미지의 대상을 체계적으로 탐색할 때 과학의 본질은 두 단계로 정리됩니다 3.
학습 역학 Learning Mechanics
- 학습 역학(Learning Mechanics) 이라는 이름은 물리 역학에서 비롯됩니다.
- 역학은 물체에 작용하는 힘이 그 운동을 어떻게 결정하는지 다루는 물리학의 분야입니다.
- 딥러닝에서는 모델이 매개변수 공간(Parameter Space) 에서 이산적인 업데이트를 통해 움직입니다.
- 매개변수·데이터·Task·학습 규칙 사이의 상호작용이 그래디언트(Gradient) 라는 형태로 매개되어 학습 궤적을 결정합니다.
- 신경망은 손실 지형의 지역 최솟값으로 수렴합니다.
- 이는 물리계가 포텐셜의 지역 최솟값으로 평형을 찾는 것과 대응됩니다.
- 이러한 구조적 유사성은 단순한 비유를 넘어, 다섯 가지 연구 흐름 각각이 물리학의 서로 다른 전통과 같은 도구와 질문을 공유한다는 관찰로 이어집니다.
증거 ① ㅣ 해석 가능한 이상화 설정 Analytically Solvable Settings
- 복잡한 시스템을 이해하는 신뢰할 수 있는 방법은, 정량 계산이 가능한 축소된 대표 설정(Pared-down Representative Setting) 을 연구하는 것입니다.
- 물리학은 조화진동자(Harmonic Oscillator), 수소 원자(Hydrogen Atom) 같은 대표 모델을 통해 더 넓은 시스템군의 직관을 얻습니다.
- 딥러닝에서도 학습 동역학이 단순해지고 많은 양이 풀리는 최소 모델들이 풍부하게 발견되고 있습니다.
- 그중 가장 결실 있는 단순화는 선형화(Linearization) 입니다. 두 가지 방향이 있습니다.
- 데이터에 대한 선형화 ㅣ \(f(\mathbf{x}; \theta)\)가 \(\mathbf{x}\)에 대해 선형
- 매개변수에 대한 선형화 ㅣ \(f(\mathbf{x}; \theta)\)가 \(\theta\)에 대해 선형
Deep Linear Networks
Deep Linear Network 는 신경망에서 모든 비선형 활성을 제거하여, 입력에 대해 선형이지만 매개변수에는 여전히 비선형인 모델입니다 5.
\[f(\mathbf{x}; \theta) = W_L W_{L-1} \cdots W_1 \mathbf{x}, \quad \theta = \{W_\ell\}_{\ell=1}^{L}, \; L \geq 2\]- 단순한 외형과 달리, Deep Linear Network는 실제 딥러닝의 많은 특성을 보존합니다.
- 안장점(Saddle Point) 이 지배하는 손실 지형 ㅣ 기울기가 0이지만 최솟값·최댓값이 아닌 지점이 학습 동역학을 지배
- 뚜렷한 상 전이(Phase Transition) ㅣ 학습이 평탄한 구간을 유지하다 급격히 변하는 움직임
- 시간 척도 분리(Timescale Separation) ㅣ 빠르게 움직이는 모드와 느리게 움직이는 모드가 뚜렷이 분리되어 진행되는 움직임
- Edge of Stability 진동 ㅣ 학습률 경계에서 매개변수가 일정하게 진동하는 현상
- 초기화 의존적인 강한 Inductive Bias(귀납 편향) ㅣ 어떤 초기화에서 출발하느냐에 따라 모델이 선호하는 해의 종류가 크게 달라지는 성질
분석은 보통 Gradient Flow(그래디언트 하강의 연속시간 극한) 기준으로, 데이터 분포에 대한 단순화 가정과 특정 초기화 아래에서 수행됩니다.
- Saxe et al. (2014) 6 의 분석은 Task-aligned Initialization 과 Whitened Input (\(\mathbf{x} \sim \mathcal{N}(0, I)\)) 하에서 성립합니다.
- Gradient Flow 동역학이 독립적인 Bernoulli ODE 들로 디커플링되고, 학습은 입력-출력 공분산의 특잇값(Singular Value) 모드별로 순차 진행됩니다.
- Deep Linear Network를 가중치 공간 동역학의 Toy Model로 다룬 해설 자료에서는 word2vec을 비롯해 이 프레임이 실제 임베딩 모델에도 적용됨이 설명되어 있습니다 7.
- 이 결과는 학습이 큰 특잇값 모드부터 순차적으로(Sequentially) 획득된다는 Greedy Low-rank Bias 를 드러냅니다.
- 이 Bias는 신호와 잡음을 분리하여 일반화에 도움을 준다고 가정됩니다.
- 비선형 신경망에서도 더 단순한 함수가 먼저 학습되는 현상이 유사하게 관측됩니다.
- 작은 초기화, 깊은 레이어, 더 강한 Mini-batch 잡음, 명시적 \(L_2\) 정규화 등은 이 Greedy 성질을 강화합니다.
Neural Tangent Kernel
매개변수에 대한 선형화 는 신경망의 Taylor 전개를 초기 매개변수 \(\theta_0\) 주변에서 1차 항까지 자른 것입니다.
\[f_{\text{lin}}(\mathbf{x}; \theta) = f(\mathbf{x}; \theta_0) + \nabla_\theta f(\mathbf{x}; \theta_0)^\top (\theta - \theta_0)\]- 특정 체제에서는 학습 과정 전반에 걸쳐 \(f(\mathbf{x}; \theta_t) \approx f_{\text{lin}}(\mathbf{x}; \theta_t)\)가 유지됩니다.
- 어떤 아키텍처든 적절한 극한을 취하면 선형화 체제로 몰릴 수 있습니다.
- 최근에는 LLM Fine-tuning이 거의 선형화된 체제에서 일어난다는 증거도 보고됩니다.
- 매개변수에 선형이므로, 학습 동역학은 선형 회귀의 것과 일치합니다. 차이는 커널입니다.
- 선형 회귀 ㅣ Gram 커널 \(K_{\text{Gram}}(\mathbf{x}, \mathbf{x}') = \mathbf{x}^\top \mathbf{x}'\)
- 선형화된 신경망 ㅣ Neural Tangent Kernel(NTK)
- Task가 최소 제곱 회귀(Least-squares Regression)이고 작은 스텝의 Gradient Descent로 학습하면, 최종 예측기는 NTK로 정의되는 Kernel Ridge Regression 해와 일치합니다 8.
- 아키텍처의 디테일은 고정된 특징맵(Feature Map) \(\nabla_\theta f(\cdot; \theta_0)\) 을 통해 NTK 구조로 들어갑니다.
- 이 NTK Eigenstructure가 선형화 모델의 Inductive Bias 를 결정합니다.
- 입력 데이터 구조를 반영하면, 임의의 타깃 함수 \(f^*\)에 대한 일반화 오차를 정확히 예측할 수 있습니다.
- Double Descent, Scaling Laws 등도 이 틀 안에서 포착됩니다.
- 다만 선형화 신경망은 Feature Learning 능력을 포착하지 못합니다.
- 샘플 복잡도 예측이 지나치게 비관적으로 나오고, 학습을 선형 문제로 환원하면서 딥러닝의 본질적 비볼록(Nonconvex) 현상을 비켜갑니다.
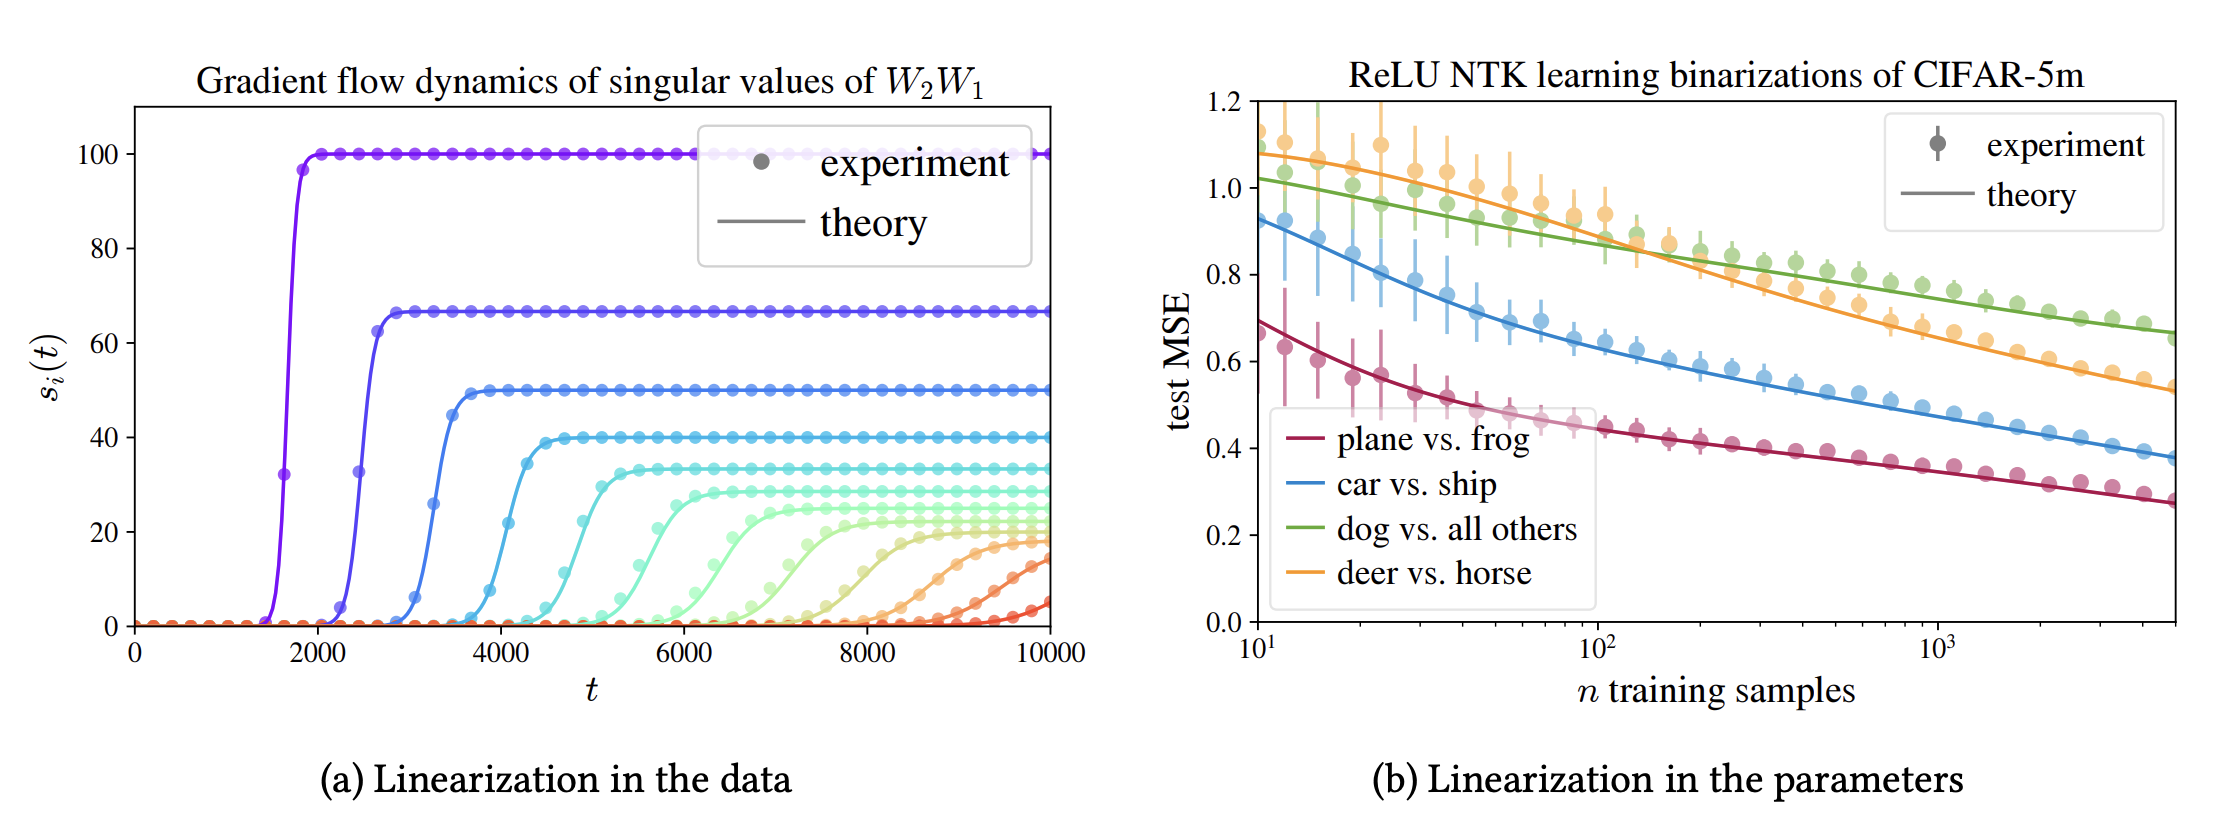 선형화가 정확한 해를 내놓는 두 사례. (왼쪽) Deep Linear Network의 Gradient Flow 동역학에서 특잇값이 순차적으로 등장, (오른쪽) ReLU NTK가 CIFAR-5m의 이진 분류 테스트 오차를 정확히 예측 2
비선형 Toy Models
- 비선형성이 매개변수와 데이터 양쪽에 살아있는 해석 가능한 Toy Model은 여전히 열린 영역입니다.
- 연구는 특정 비선형 메커니즘을 데이터 가정과 함께 풀리게 만드는 쪽으로 진행되어 왔습니다.
- Gaussian 입력 + 구조화 타깃 (Single-index, Multi-index Model)
- Quadratic 활성 2-Layer Network ㅣ 정확한 asymptotics, 학습 동역학, Scaling Law 특성 규명
- Logistic Loss 아래 Homogeneous Network의 Max-margin 수렴
- Teacher-student 구조에서 저차원 Summary Statistic으로의 축약
- Modular Arithmetic에서의 학습된 알고리즘 구조
- Nonlinear Attention의 Solvable Model
- Feature Learning 을 반영한 개선된 Scaling Law
- 지금까지의 성과는 비선형 학습 동역학의 일부씩을 포착하는 것에 머물고, 통합적 프레임워크는 아직 등장하지 않았습니다.
증거 ② ㅣ 통찰을 주는 극한 Insightful Limits
- 현대 딥러닝 시스템은 거대합니다. 수백 개의 아키텍처 구성요소, 수천억 매개변수, 수조 토큰이 상호작용합니다.
- 이 많은 자유도를 개별 매개변수 수준에서 추적하는 미시적인 이론은 거의 불가능해 보입니다.
- 그러나 복잡계는 종종 크기가 사실상 무한대인 극한 에서 단순한 수학적 구조를 드러내며, 이 구조는 유한 시스템에도 유의미한 정보를 줍니다.
- ex. 이상기체 법칙 \(PV = nRT\)는 무한 입자수의 열역학 극한(Thermodynamic Limit) 에서 유도되지만, 유한 부피 기체에도 잘 적용됩니다.
Infinite Width 극한과 Lazy/Rich 이분법
- 깊은 신경망의 동역학은 각 Hidden 층의 뉴런 수를 무한으로 보낼 때 종종 단순해집니다.
- 이 극한에서는 개별 뉴런이 아닌 뉴런 집단의 진화를 분포로 서술하는 Mean-field 움직임이 나타납니다.
다만 무한 폭 극한을 안정적으로 만들기 위해서는 초기화 스케일을 폭에 맞춰 축소해야 하며, 그 축소율에 따라 두 가지 서로 다른 극한 움직임이 생깁니다.
- Lazy, Kernel, Linearized Regime
- Hidden 뉴런 입력이 폭이 커져도 발산·소멸하지 않도록 매개변수 크기를 \([\text{width}]^{-1/2}\)로 감소시키면, LeCun 초기화 규칙과 일치합니다.
- 이렇게 초기화된 무한 폭 신경망을 그대로 학습하면, 매개변수와 Hidden 표현은 거의 변하지 않는데도 그 작은 변화가 누적되어 출력 함수에 상당한 변화를 만듭니다.
- 학습 동역학은 매개변수에 선형이 되고, 전체 움직임은 NTK로 서술됩니다 8.
- Hidden Representation이 거의 변하지 않으므로 Feature Learning은 일어나지 않습니다.
- Rich, Active, Feature-learning Regime
- 최종층 가중치를 \([\text{width}]^{-1}\)로 더 강하게 축소하면, 무한 폭에서도 학습이 Feature Learning을 유도합니다 9.
- 초기화 시 함수는 trivially zero에 가깝지만, 학습 중에 매 Gradient Step마다 order-one 크기로 유의미하게 성장할 수 있습니다.
- 이 아이디어는 얕은 Mean-field Network에서 시작되어, 임의 깊이의 신경망에 대한 Maximal Update Parametrization(µP) 으로 확장되었습니다.
- Rich 체제에서 은닉 피처는 데이터 구조에 맞춰 적응하며, 뉴런 집단은 데이터에 숨은 서로 다른 Feature에 특화됩니다.
- 초기화가 더 작아지면 Deep Linear Network에서 본 Greedy Low-rank Bias가 다시 나타납니다.
- Lazy/Rich 이분법은 초기화 스케일에 민감하게 의존하며, 유한 폭 신경망에서도 유사한 움직임이 관찰됩니다.
- 출력을 축소하면 Feature Learning이 촉진되고, 출력을 확장하면 Lazy 체제로 몰립니다.
- 이 민감성은 Inductive Bias 에 대한 광범위한 문헌과 연결됩니다.
- 학습 설정의 작은 변화가 완전히 다른 해 클래스로 학습을 이끌 수 있습니다.
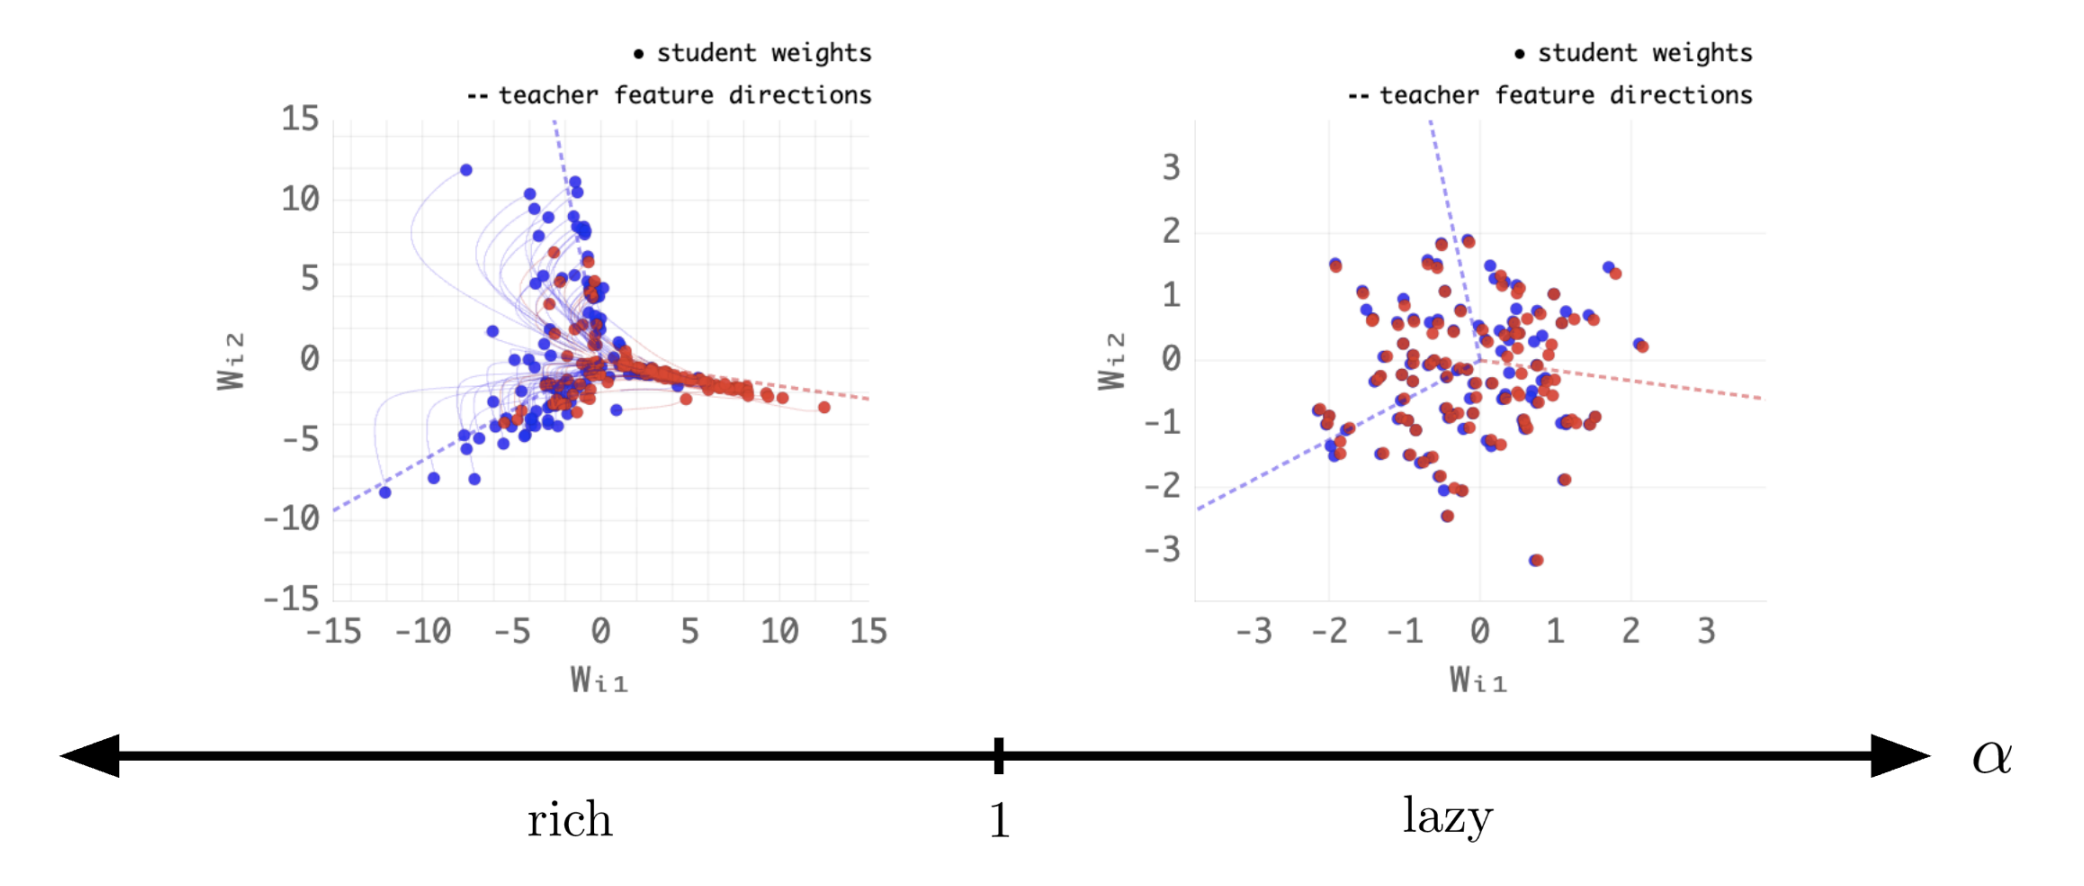 출력 Multiplier의 크기가 Rich(왼쪽, α=0.1)와 Lazy(오른쪽, α=30) 동역학을 결정함 2
Infinite Depth · Joint Scaling
- Residual Network의 무한 깊이 극한도 각 층의 기여를 적절히 축소하면 안정적으로 정의됩니다.
- \([\text{depth}]^{-1}\) 축소 ㅣ Residual Stream이 깊이에 걸쳐 매끄럽게 변하는 극한 (Neural ODE 양상)
- \([\text{depth}]^{-1/2}\) 축소 ㅣ 확률 미분 방정식(Stochastic Differential Equation, SDE) 의 확산처럼 움직이는 극한
- 두 극한은 Transformer 같은 실제 아키텍처에서 질적으로 다른 해로 수렴합니다.
- 배치 크기가 무한으로 가면 Population Gradient Descent 에 도달하고, 학습률이 0으로 가면 Gradient Flow 에 도달합니다.
무한소 Weight Decay를 더하고 학습 시간을 무한으로 보내면, 먼저 Loss가 수렴하고 그 다음 Loss 값을 고정한 채 매개변수 노름 최소화가 이루어집니다.
- Joint Scaling ㅣ 데이터셋 크기와 매개변수 수를 모두 무한으로 보내되, 그 비율을 유한 값으로 고정하는 극한도 중요합니다.
- Compute-optimal Scaling Law 연구와 Hyperparameter Transfer 현상 분석에 필수적입니다.
- 데이터가 고정된 무한 매개변수 극한은 완벽한 보간이 가능해 Scaling 거동을 포착하지 못합니다.
이산화 가설 The Discretization Hypothesis
- 딥러닝에서 극한이 되풀이해서 유효한 도구가 되는 것은, 많은 과학 분야에 걸친 연구 결과입니다.
- 많은 이론가는 실제 유한 신경망이 무한 크기 모델의 Noisy·Finite 근사에 불과하다는 직관을 공유하고 있습니다.
- 편미분 방정식을 공간·시간으로 이산화하여 수치해법을 얻는 것과 같은 구조로, 폭과 깊이는 공간·시간의 역할을 합니다.
- 학습률, 배치 크기, 데이터셋 크기 같은 다른 유한 하이퍼파라미터도 같은 관점에서 이해될 수 있습니다.
- 이 직관이 이산화 가설(The Discretization Hypothesis) 입니다.
- 유한 효과가 성능을 떨어뜨리는 대신 데이터·시간·메모리·연산 비용을 줄여준다는 의미입니다.
- 아직 엄밀히 증명되지는 않았지만, 대형 모델의 해석적 분석 대부분이 이 가설 위에 암묵적으로 놓여 있습니다.
증거 ③ ㅣ 단순한 경험 법칙 Simple Empirical Laws
- 딥러닝은 측정 가능성(Measurability) 이 높은 분야입니다.
- 학습 전·중·후에 광범위한 양을 쉽게 추적할 수 있습니다.
- 가장 법칙적(Lawful) 인 양은 여러 가중치와 샘플에 걸친 거시적 집계 통계입니다.
- 이러한 양들 사이에는 종종 단순한 경험 법칙이 성립합니다.
- 이 패턴은 정량 과학에서 오래된 전통이며, Kepler, Snell, Boyle, Hooke, Faraday, Ohm, Poiseuille, Planck의 법칙은 모두 경험 규칙으로 먼저 발견되고 나중에 깊은 원리로 설명되었습니다.
Neural Scaling Laws
- 기계 학습 시스템에서 가장 중요한 단일 측정값은 Test Loss 입니다.
- 거대한 딥러닝 시스템의 복잡성을 생각하면, Test Loss는 수많은 하이퍼파라미터의 복잡한 함수일 것으로 예상됩니다. 그러나 실제로는 그렇지 않습니다.
- 아키텍처 계열이 고정되면, 최종 Loss는 세 스칼라 변수의 거듭제곱 법칙(Power Law) 으로 예측됩니다 10.
- Compute
- Dataset Size
- Parameters
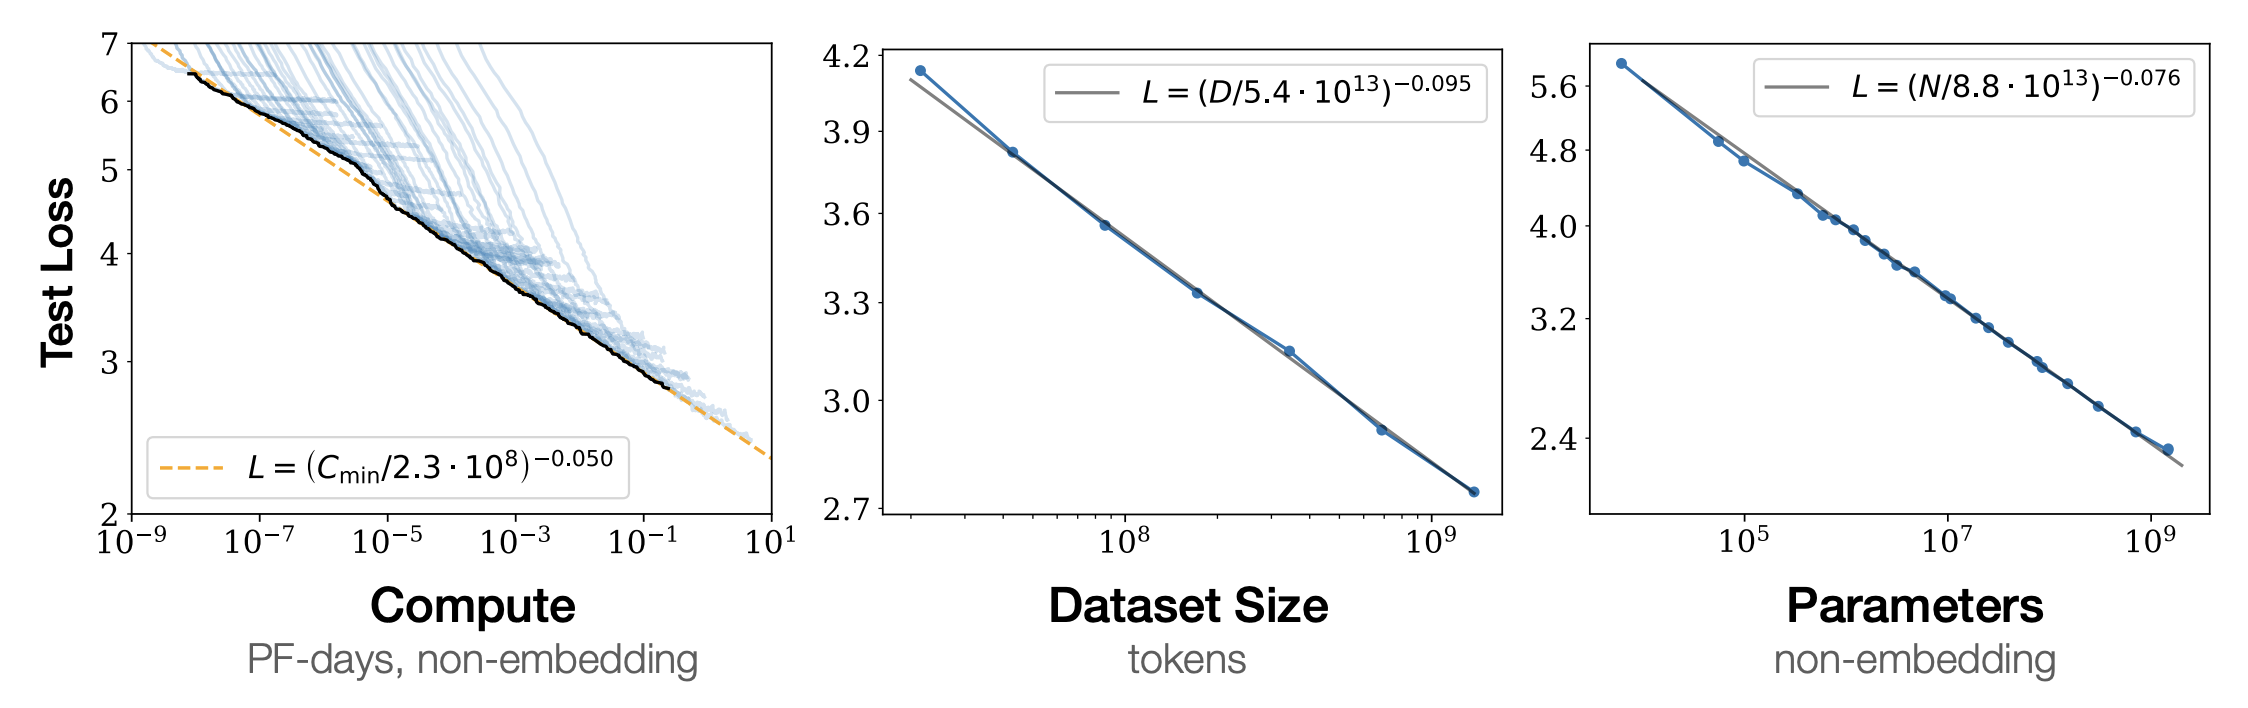 대형 신경망의 Loss가 Compute, Dataset Size, Parameter 수에 대해 거듭제곱으로 감소. Log-log 축에서 선형 210
- 왜 Test Loss가 이 변수들에 대해 거듭제곱 법칙을 따르는지, 그리고 지수가 무엇에 의해 결정되는지는 아직 완전히 풀리지 않았습니다.
- 데이터 다양체의 차원(Dimensionality), Feature Superposition, 과제 구조에 내재된 거듭제곱, 아키텍처·옵티마이저의 디테일 등이 후보로 제시되어 왔습니다.
- 현재로서 모든 실제 설정에서 지수를 제1원리에서 예측할 수 있는 프레임워크는 존재하지 않습니다.
- Quanta Hypothesis 는 이 저변 설명의 한 후보로, 학습을 이산적인 “Quanta”의 획득으로 모델링하는 접근입니다 11.
- 데이터 구조와 신경망이 학습하는 해의 구조에 대한 강한(비공식적) 추측을 제시하며, 거시적 Scaling 사실과 저수준의 메커니즘 수준 해석을 잇는 다리 역할을 지향합니다.
- 지수를 완전히 예측하지는 못하지만, Scaling Law와 Mechanistic Interpretability를 하나의 프레임으로 엮으려는 시도의 한 형태로 볼 수 있습니다.
Edge of Stability
- 모델의 가중치가 학습 과정에서 어떤 궤적을 그리는지에 대해 알고 싶지만, 손실에 대한 지형은 일반적으로 너무 복잡해서 직접 시각화해도 뚜렷한 규칙성을 찾기 어렵습니다.
- 그럼에도 가중치 궤적의 거시적 특성에서는 Robust한 패턴이 발견됩니다. 그중 하나가 Sharpness 입니다.
- Sharpness는 매개변수에 대한 Hessian의 최대 고유값으로 정의됩니다.
- 학습률 \(\eta\)로 Full-batch Gradient Descent를 수행하면, Sharpness는 두 단계를 거칩니다 12.
- Progressive Sharpening ㅣ 점진적으로 증가
- Edge of Stability ㅣ \(2/\eta\) 근처에서 Plateau
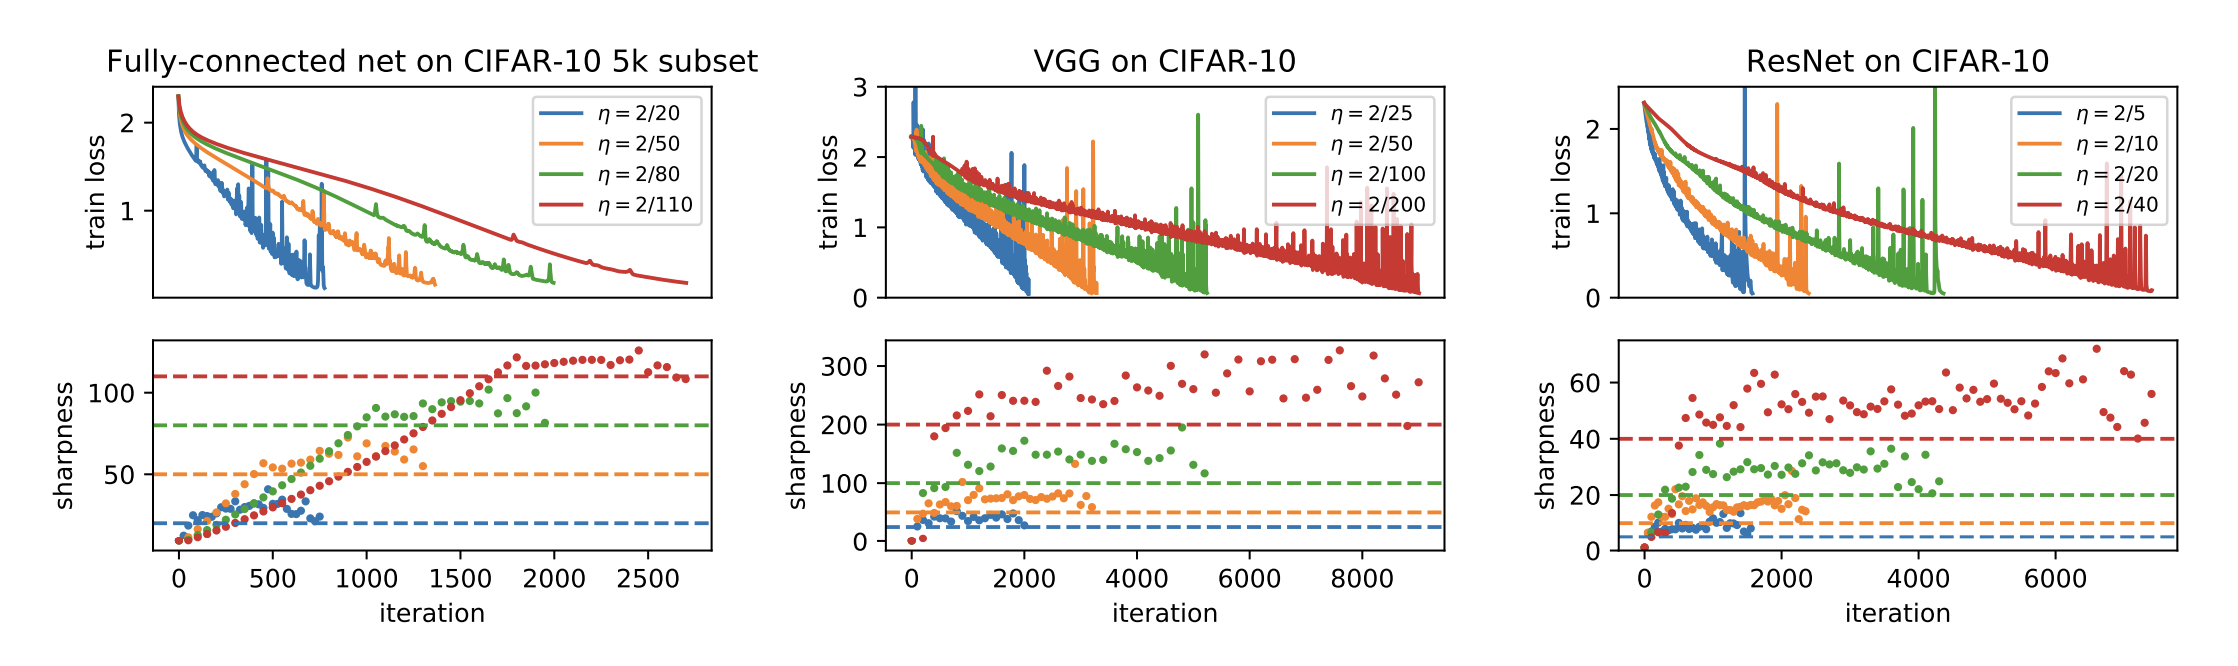 세 가지 아키텍처(FC, VGG, ResNet)를 CIFAR-10에서 Full-batch Gradient Descent로 학습. 학습률 \(\eta\)에 관계없이 Sharpness가 \(2/\eta\) 부근(점선)으로 올라가 머무름 212
- Progressive Sharpening은 Deep Linear Network에서 증명되었지만, 실제 비선형 신경망에 적용할 수 있는 정량적인 설명은 아직입니다.
- Edge of Stability가 \(2/\eta\) 근처로 안정화되는 것은 비교적 잘 이해됩니다.
- 볼록 최적화에서 안정한 최대 Sharpness가 \(2/\eta\)이므로, 이보다 큰 Sharpness는 매개변수 진동이 커집니다.
- 3차 손실 곡률(3rd-order Curvature)의 거시적 성질이 2차 Sharpness를 \(2/\eta\)에서 안정화시킨다는 설명이 제시되어 있습니다.
- 전체 학습 궤적이 곡률 페널티 Gradient Flow + 불안정 방향의 진동으로 분해된다는 결과도 보고되어 있습니다.
Neural Collapse · Feature Ansatz · 보존 법칙
Hidden representation과 가중치의 거시적 성질에서 단순한 식을 따르는 경우가 더 있습니다.
- Neural Collapse ㅣ \(C\)개 클래스를 분류하는 신경망에서, 학습이 끝날 때 각 클래스의 최종 Hidden 표현이 자신의 클래스 평균 주변으로 좁게 뭉치고, \(C\)개의 클래스 평균이 정규 심플렉스(Regular Simplex) 를 형성합니다.
- Cross-entropy Loss와 소량의 Weight Decay가 적용될 때, 이 기하 배치가 자연스러운 에너지 최소화 구성임이 증명됩니다.
Neural Feature Ansatz ㅣ 신경망의 반대쪽 끝에서, 첫 레이어 가중치에 대한 Robust 규칙성이 나타납니다 13.
\[W_1^\top W_1 \propto \mathbb{E}_{\mathbf{x} \sim P_{\text{data}}}\left[ \nabla_{\mathbf{x}} f(\mathbf{x}; \theta)\, \nabla_{\mathbf{x}} f(\mathbf{x}; \theta)^\top \right]\]- \(\nabla_{\mathbf{x}} f(\mathbf{x}; \theta)\) ㅣ 입력 \(\mathbf{x}\)에 대한 신경망의 Jacobian
- 이 규칙은 Heuristic이고 Inexact하지만, \(W_1^\top W_1\)의 Top Eigenvector 같은 양을 상당히 정확히 예측합니다.
- 더 깊은 층에서도 유사한 Heuristic이 성립하며, 부분적 이론 설명이 진행 중입니다.
- Gradient Flow 보존 법칙 ㅣ Linear Network에서는 연속한 두 층의 공분산·그램 행렬의 차이 \(W_\ell W_\ell^\top - W_{\ell+1}^\top W_{\ell+1}\) 이 Gradient Flow 하에서 보존됩니다.
- 처음에는 Linear Network의 특이한 성질로 보였으나, 이후 매개변수화의 연속 대칭성(Noether 원리의 한 사례) 에서 유도됨이 밝혀졌습니다.
- ReLU 같은 Homogeneous 활성의 Rescaling 대칭, Batch Normalization 앞단의 Scale 대칭, Softmax 앞 logit의 Translation 대칭, Attention의 Key-Query 간 Rotation 대칭이 각각 대응되는 보존량을 갖습니다.
증거 ④ ㅣ 하이퍼파라미터의 이론 Theories of Hyperparameters
- 딥러닝 학습에는 수많은 수치적 손잡이, 즉 하이퍼파라미터가 있습니다.
- 최적화 ㅣ 학습률, 배치 크기, 모멘텀, 초기화 분산
- 아키텍처 ㅣ 폭, 깊이, 출력 Multiplier
- 실무자에게는 튜닝 비용 문제이자, 연구자에게는 과학적 실험을 해석할 때 혼란을 주는 Confounding Factor 문제입니다.
- 최근 몇 년 사이에야 하이퍼파라미터를 분리하고 이해할 수 있다는 관점이 뚜렷해졌습니다.
최적화 하이퍼파라미터
- SGD의 두 하이퍼파라미터(학습률, 배치 크기)는 종종 동시 Rescaling 하에서 불변 입니다.
- 학습률과 배치 크기를 둘 다 두 배로 하면, 궤적은 거의 그대로 유지됩니다.
- 이 Linear Scaling Rule 은 SGD를 확률 미분 방정식(SDE) 의 이산화로 해석할 때 자연스럽게 예측됩니다.
- Adam 같은 적응 옵티마이저에서는 학습률이 배치 크기의 제곱근과 함께 스케일되어야 한다는 결과로 확장됩니다.
- 이 불변성 관점은 배치 크기 사이의 스케일링을 설명하지만, 배치 크기 자체의 선택을 설명하진 않습니다.
- 배치 크기 선택은 직렬 시간과 총 연산량 사이의 자원 트레이드오프를 다루는 문제이며, 이 둘 간의 Pareto Frontier는 쌍곡선 형태를 띠는 모델로 설명됩니다.
- 옵티마이저의 암묵적 효과는 손실 곡률의 암묵적 정규화(Implicit Regularization) 라는 가설로 통합되고 있습니다.
- 큰 학습률과 작은 배치 크기가 더 강한 곡률 정규화를 유도한다는 관찰이 있습니다.
- 목적함수를 3차까지 Taylor 전개하면, 진동하거나 요동치는 동역학이 자동으로 곡률 정규화를 유도함을 보일 수 있습니다.
- Full-batch에서는 실제 신경망의 전체 궤적이 곡률 페널티 Gradient Flow 로 잘 모델링된다는 결과도 보고되어 있습니다.
µP · Hyperparameter Transfer
- 아키텍처 하이퍼파라미터(폭, 깊이, 출력 Multiplier)를 최적화 하이퍼파라미터(학습률, 초기화 분산)와 분리하는 연구 흐름이 성공적이었습니다.
Tensor Programs 프레임워크 는 이를 명시적으로 수행합니다 14. 학습률을 다음과 같이 분리합니다.
\[\eta = \eta_0 \cdot [\text{width}]^{c}\]- \(\eta_0\) ㅣ 스케일에 독립적인 계수
- \(c\) ㅣ 폭 의존 지수
- 이 분해에서 자연스러운 질문은 “무한 폭에서 비자명하고 발산하지 않는 움직임을 유지하려면 지수를 어떻게 설정해야 하는가”입니다.
- 모든 비자명·비발산 Scaling은 두 가지 극한 중 하나로 귀결됩니다.
- Neural Tangent Parameterization(NTP) ㅣ Feature가 학습 중 변하지 않음
- Maximal Update Parametrization(µP) ㅣ Feature가 진화함
- Feature Learning이 대부분의 과제에서 필수적이므로, 사용해야 할 Scaling은 µP 입니다.
- 이 이해는 Hyperparameter Transfer 를 가능하게 합니다.
- 작은 Proxy Model에서 튜닝한 하이퍼파라미터를 큰 모델로 그대로 옮겨도 Near-optimal로 유지됩니다 15.
- 일반 매개변수화에서는 폭이 커질수록 최적 학습률이 왼쪽으로 이동합니다.
- µP에서는 폭이 바뀌어도 최적 학습률이 거의 일정하게 유지됩니다.
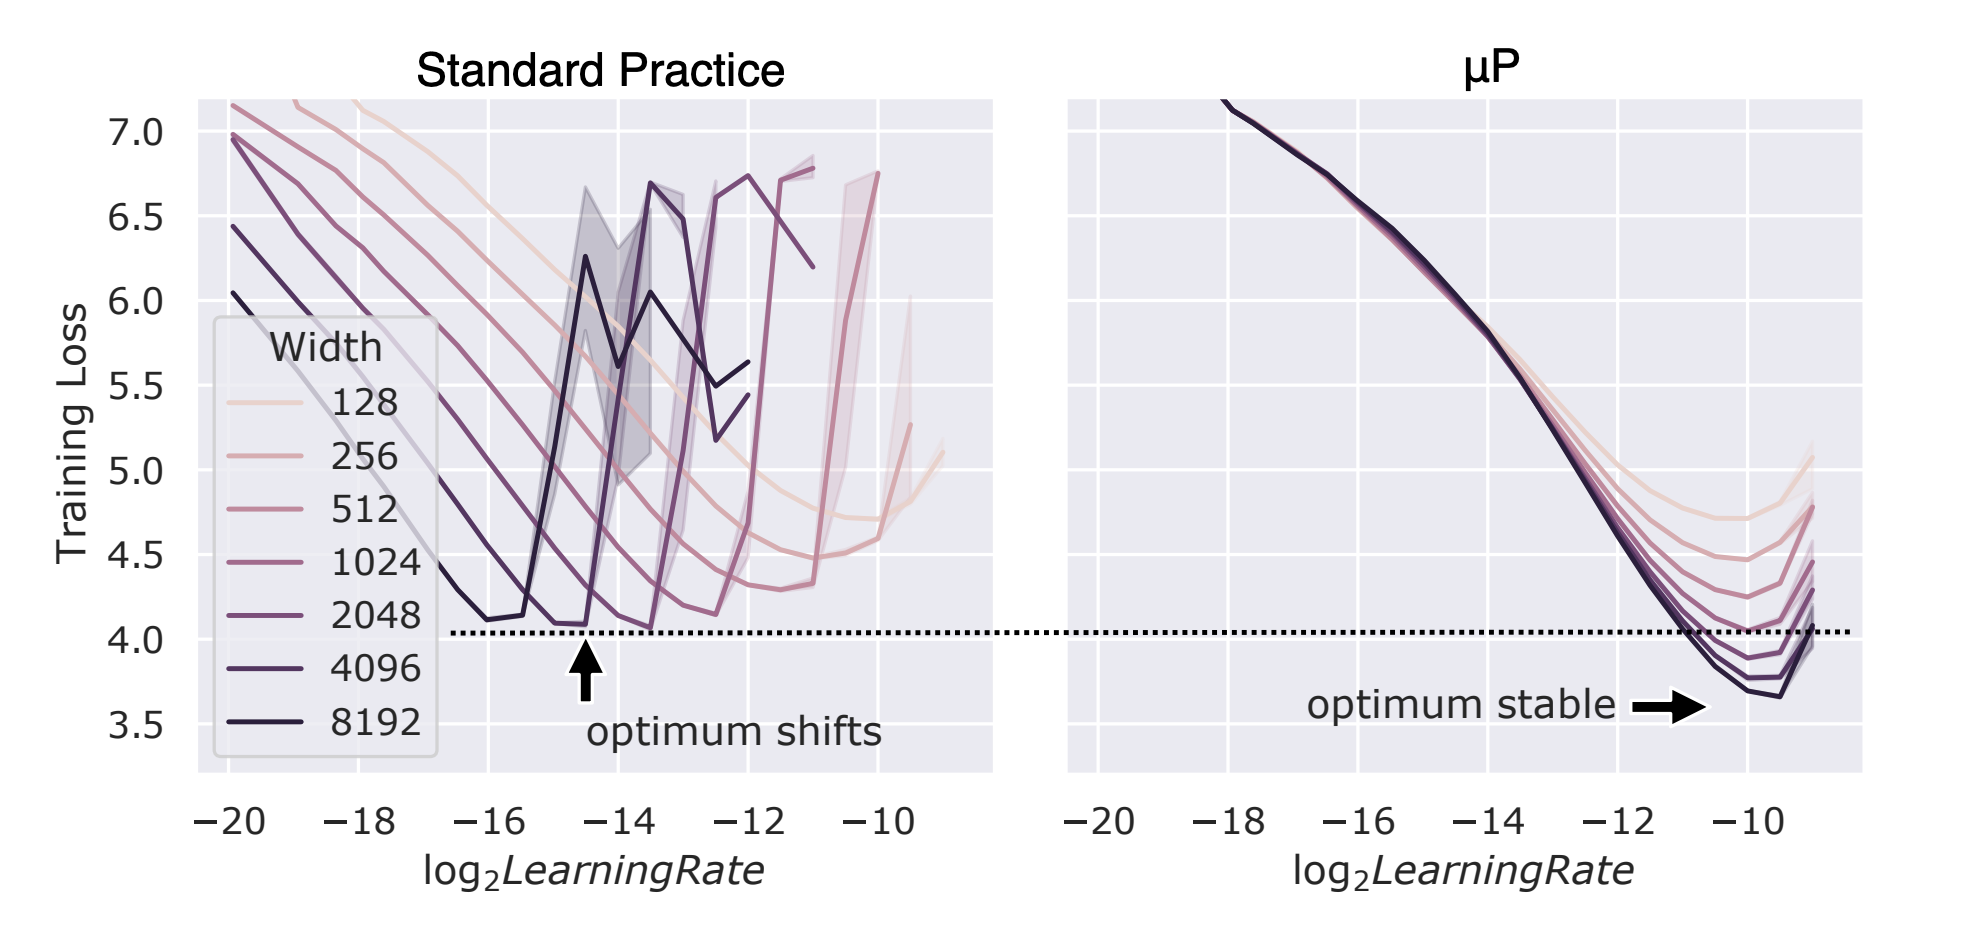 WikiText-2에서 폭을 달리한 Transformer의 학습 손실 대 학습률. (왼쪽) 표준 매개변수화에서는 폭이 커질수록 최적 학습률이 이동. (오른쪽) µP에서는 폭이 바뀌어도 최적 학습률이 거의 고정 215
- 이 접근은 이후 Depth Scaling 으로도 확장되었으며, 다른 Scaling 차원과 결합하는 방향이 열린 과제로 남아 있습니다.
증거 ⑤ ㅣ 보편적 현상 Universal Phenomena
- 딥러닝은 매번 동일한 레시피를 따르는 분야가 아닙니다. 아키텍처·데이터셋·학습 알고리즘·목적함수가 모두 다양하게 조합됩니다.
- 이러한 다양성에도 불구하고, 보편적 현상(Universal Phenomena) 이 관측됩니다.
- 이 보편성이 이론의 신호 로 읽히는 이유는 다음과 같습니다.
- 서로 다른 복잡계가 같은 거시적 거동을 보일 때, 그 공통 거동은 각 시스템의 세부사항이 아니라 공통 요소에만 의존해야 합니다.
- 즉, 보편 현상이 많을수록 어떤 모델 하나보다 더 단순한 설명이 존재할 가능성이 커집니다.
- 물리학에서 임계 현상(Critical Phenomena) 과 재규격화 흐름(Renormalization Group Flow) 이 수행한 역할이 딥러닝에도 가능할 수 있음을 시사합니다.
- 보편성은 세 가지 시각에서 나타납니다.
아키텍처 간 Inductive Bias
- 주어진 과제에서 많은 대안 아키텍처가 비슷한 성능을 냅니다.
- 컴퓨터 비전에서 CNN과 Transformer는 Compute, Data, 학습 레시피를 맞추면 유사한 성능을 보입니다.
- Diffusion Model에서는 UNet과 Transformer가 같은 Noise Sample을 받았을 때 거의 동일한 이미지를 생성할 정도로 입력-출력 관계가 유사합니다.
- 이러한 결과는 외형이 달라도 아키텍처들이 비슷한 Inductive Bias 를 공유함을 시사합니다.
- Locality 와 기하 구조에 대한 Adaptivity 를 가정하면 Diffusion Generative Model의 정량 거동이 꽤 정확히 예측된다는 결과도 있습니다.
- 이는 아키텍처별 이론이 아니라 아키텍처를 가로지르는 공통 이론이 가능하다는 신호입니다.
- 아키텍처의 디테일보다, 학습 동역학이 데이터 구조를 어떻게 활용하는지가 더 본질적일 가능성을 보여줍니다.
데이터의 보편적 구조
- No-free-lunch 정리 는 완전히 임의의 데이터에 대해 공통 학습 전략으로 일반화할 수 없음을 말합니다.
- 따라서 딥러닝의 성공은 데이터에 공통된 특정 구조에 의존합니다.
- 많은 이미지·오디오 신호는 거듭제곱 Spectrum, Sparsity 패턴, Multiscale 구조를 공유하고, 범용 Wavelet 기저 로 분석됩니다.
- 자연어·인공어 전반에 걸쳐 Zipf 법칙(단어 빈도의 거듭제곱 분포)이 성립합니다.
- 이미지·텍스트 모두 위계적 조합 구조(Hierarchical Compositional Structure) 로 모델링됩니다.
- 이러한 공유 통계 성질이, 하나의 학습 알고리즘이 겉보기에 무관한 데이터셋을 모두 다룰 수 있는 부분적 이유가 됩니다.
- 이는 딥러닝 이론이 결국 “데이터 구조의 이론”과 분리될 수 없다는 시사점을 줍니다.
- 공통된 통계 구조가 성능을 설명한다면, 그 구조를 정량화하는 것이 학습 역학의 핵심 과제가 됩니다.
표현의 보편성
- 더 깊이 들어가면, 서로 다른 신경망이 학습하는 표현이 서로 닮아 있다는 관찰이 있습니다.
- 무작위 초기화, 폭, 아키텍처에 걸쳐 유사
- 다른 데이터셋(ImageNet, Places-365), 다른 목적함수(지도·자기지도), 다른 모달리티(Vision·Language)에서도 유사
- 모델 크기와 성능이 커질수록 유사성이 강해져, 활성이 보편 표현(Platonic Representation) 으로 수렴한다는 가설이 제기됩니다.
- 근거:
- Random Feature 표현의 수렴은 Feature Kernel에 대한 큰 수의 법칙의 귀결로 볼 수 있습니다.
- Deep Linear Network에서는 SGD의 암묵적 정규화(Implicit Regularization) 로부터 유도 가능합니다.
- 더 넓은 설정에서는 데이터의 보편 구조 가 궁극 원인일 가능성이 제기됩니다.
- 다만 표현의 “유사성”을 재는 메트릭 선택이 결과에 결정적 영향을 미친다는 한계가 알려져 있으며, 이 보편성의 범위와 메트릭 선정은 열린 질문입니다.
- 표현 보편성은 이론 측면에서 한 모델에서 유도한 결과가 다른 모델로 전이될 수 있다는 근거를 제공합니다.
- 아키텍처·목적함수·초기화를 가로지르는 학습 동역학의 공통 극한이 존재할 수 있음을 시사합니다.
- 데이터의 보편 구조가 궁극 원인이라면, 신경망 내부 표현 연구는 사실상 데이터 생성 과정에 대한 연구로 환원될 가능성이 있습니다.
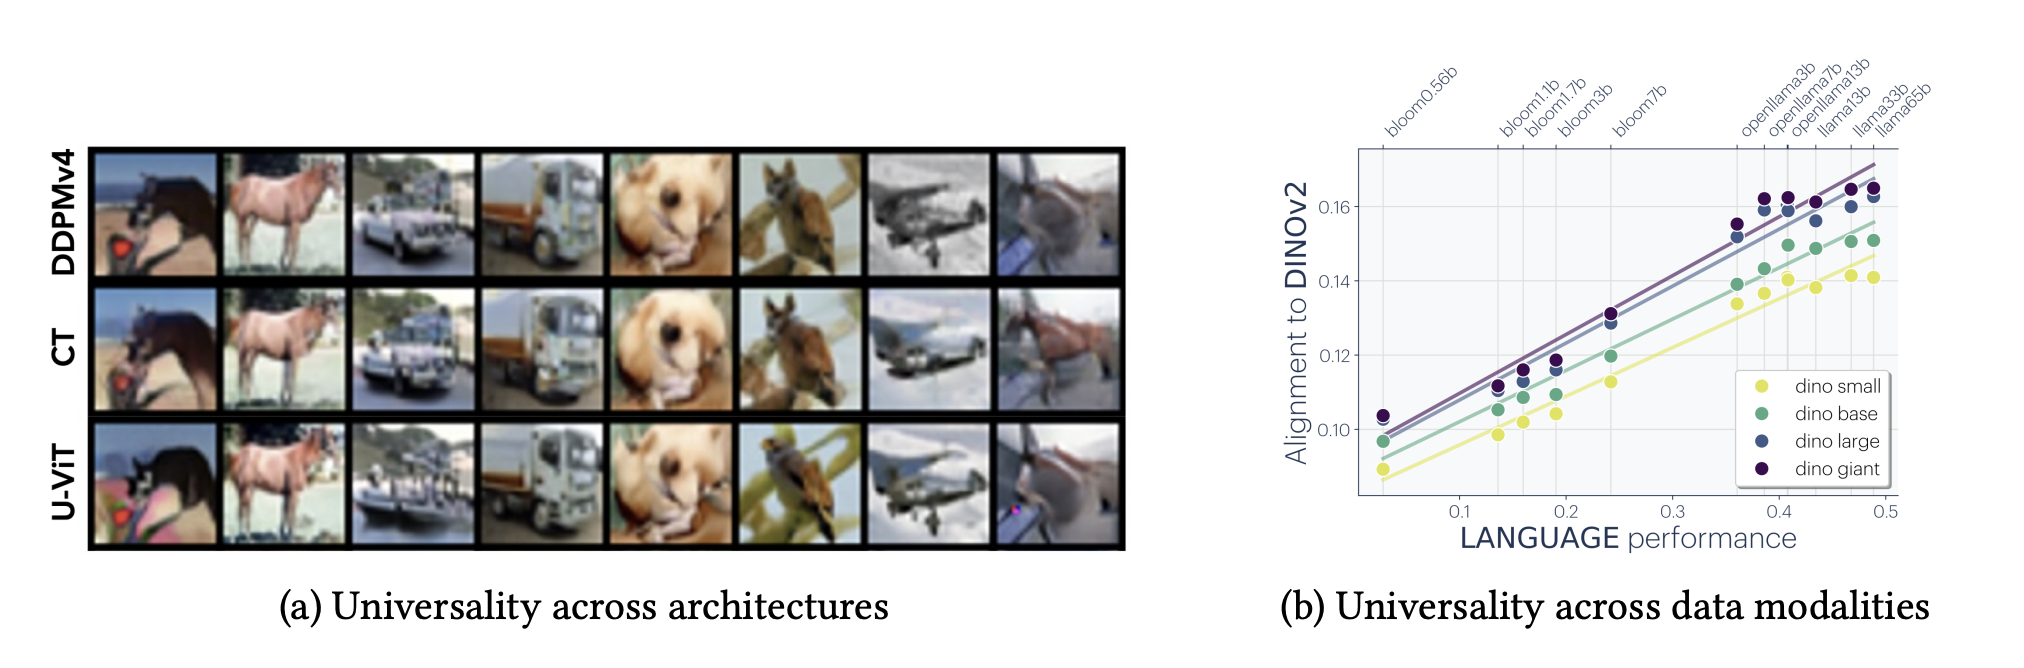 아키텍처와 데이터 모달리티를 가로지르는 보편성. (왼쪽) DDPM, Consistency Model, U-ViT 등 서로 다른 Diffusion Model이 같은 입력 Seed에서 동일한 이미지 생성. (오른쪽) 언어 모델의 성능이 높아질수록 내부 표현이 Vision Model과 유사해짐 2
학습 역학의 성격
- 다섯 가지 증거를 거쳐 학습 역학이 어떤 모습일지 윤곽이 잡힙니다. 각 증거는 물리학에서 이미 익숙한 도구와 짝지어집니다.
| 접근 | 딥러닝에서의 예 | 물리학에서의 대응 |
|---|---|---|
| Solvable Settings | Deep Linear Networks, Kernel Regression, Multi-index Models | Harmonic Oscillator, Hydrogen Atom, Ising Model |
| Simplifying Limits | Lazy vs. Rich, Infinite Width/depth, Small Initialization | Thermodynamic Limit, Classical Limit, Hydrodynamic Limit |
| Simple Empirical Laws | Neural Scaling Laws, Edge of Stability, Neural Feature Ansatz | Kepler, Snell, Boyle, Hooke, Ohm, Planck 등의 법칙 |
| System Parameters | Step Size as Sharpness Regularization, µP와 Width-scaling | Scaling Analysis, Nondimensionalization |
| Universal Phenomena | 아키텍처 간 공유되는 Inductive Bias와 Representations | Critical Phenomena, Renormalization Group Flow |
다른 관점들과의 관계
딥러닝 이론은 여러 관점에서 전개되어 왔으며, 이들은 서로 상보적 입니다. 모두 학습 역학을 직접 추구하거나, 학습 역학으로부터 혜택을 얻습니다.
- 통계적 관점(Statistical Perspective)
- 고전 학습 이론은 표현력(Expressivity), 복잡도 제어(Complexity Control), 계산 효율성(Computational Efficiency) 사이의 균형으로 학습을 정식화합니다.
- 딥러닝은 충분히 표현력이 있지만, 그 거대한 함수 클래스 안에서 좋은 함수가 어떻게 선택되는지가 명확하지 않습니다.
- 현대 통계적 관점은 두 가지 답을 내놓습니다: 단순하고 일반화가 잘 되는 함수에 대한 암묵적 Inductive Bias, 그리고 과매개화 덕분에 최적화가 쉬워진다는 사실.
- 이 답을 정량화하려면 학습 과정 자체를 들여다볼 수밖에 없고, 이는 곧 학습 역학으로 이어집니다.
- 정보이론 관점(Information-theoretic Perspective)
- 학습을 데이터셋에서 정보를 뽑아내는 과정으로 보고, 좋은 학습은 예측에 유용한 정보를 추출하고 나머지를 버리는 것으로 설명합니다.
- 데이터셋을 모델의 매개변수나 은닉 표현으로 압축(Compression) 하는 것이 일반화와 이어진다는 그림입니다.
- 아키텍처·학습 과정이 어떻게 이 압축을 실제로 구현하는지, 어떤 요인이 그 성공을 좌우하는지는 결국 학습 동역학의 문제입니다.
- 딥러닝의 물리학(Physics of Deep Learning)
- 기계 학습 물리학의 전통을 잇는 관점으로, 신경망 학습의 Average-case 이론을 추구합니다.
- 2024년 노벨 물리학상이 기계 학습과 물리의 관계를 공식적으로 인정한 바 있습니다.
- 이 커뮤니티의 작업이 사실상 학습 역학 그 자체라 할 수 있습니다.
- 신경과학적 관점(Perspectives from Neuroscience)
- 신경계가 수행하는 계산이 근사적 확률 추론(Approximate Probabilistic Inference) 이라는 가설에서 출발해 예측을 유도하는 접근이 있습니다.
- 시각 피질의 Edge-selective 세포와 CNN의 Edge-selective Receptive Field 사이의 평행이 한 예입니다.
- Systems Neuroscience는 뇌 일부를 해석 가능한 Circuit으로 분해하고 표현 구조를 역공학합니다.
- 이는 Mechanistic Interpretability 와 공유되는 아이디어입니다.
- 신경계가 수행하는 계산이 근사적 확률 추론(Approximate Probabilistic Inference) 이라는 가설에서 출발해 예측을 유도하는 접근이 있습니다.
- Developmental Interpretability · 특이 학습 이론
- Singular Learning Theory(Watanabe, 2009) 를 기반으로, Bayesian 관점에서 학습을 손실 지형의 기하가 매개하는 순차적 상전이(Sequential Phase Transition) 로 이해하려는 접근입니다.
- 학습 역학과 같은 목표를 공유하되, 도구집합이 다릅니다. 교차 수분의 여지가 큽니다.
Mechanistic Interpretability와의 공생
- Mechanistic Interpretability 는 학습된 신경망의 내부 메커니즘(Features · Circuits · Learned Algorithms)을 인간이 이해 가능한 형태로 역공학하는 접근입니다.
- 학습 역학과 Mechanistic Interpretability는 같은 시스템을 다른 추상 수준에서 다루는 상보적 관점입니다.
- 학습 역학 = 딥러닝의 물리학(Physics)
- Mechanistic Interpretability = 딥러닝의 생물학(Biology)
- 두 분야는 함께 가야 서로 이득을 봅니다.
학습 역학이 Mechanistic Interpretability를 지원할 수 있는 두 축은 다음과 같습니다.
- 핵심 가정의 수식화 ㅣ Mechanistic Interpretability가 암묵적으로 전제하는 가정들을 수학적으로 명시하고, 어떤 체제에서 성립하고 어떤 체제에서 깨지는지 밝히는 작업입니다.
- Linear Representability ㅣ 피처가 활성 공간의 의미 있는 방향에 대응
- Locality ㅣ 피처·회로가 특정 모델 구성요소에 국소화
- Sparsity ㅣ 개별 피처·회로가 소수 입력에 대해서만 활성화
- Compositionality ㅣ 복잡한 표현·계산이 단순 모듈의 조합으로 생성
- 메커니즘의 형성 과정 설명 ㅣ Mechanistic Interpretability는 주로 신경망이 무엇을 학습했는지를 서술합니다. 학습 역학은 어떻게 그리고 왜 그런 메커니즘이 형성되는지를 설명합니다.
- Induction Head 의 형성
- Grokking 과 Progress Measure
- Circuit 형성의 갑작스러운 상전이(Sudden Phase Transition)
QnA
딥러닝의 수학적 이론 추구에 대한 흔한 반론은 다음과 같이 정리되며, 각각에 대한 대답이 있습니다.
- “수십 년간 시도해도 안 됐는데 지금이라고 다를 게 있나”
- 딥러닝의 실용적 성공은 비교적 최근 일이고, 새로운 현상을 측정·채굴할 수 있는 실험 시스템이 풍부해졌습니다.
- Universal Representation처럼 최근 몇 년의 스케일링이 드러낸 현상도 있습니다.
- 분야가 커지면서 물리학·수학·신경과학에서 유입된 다양한 관점이 결합하고 있습니다.
- 주요 과학의 발전은 보통 수십 년 단위이므로, 지금까지의 미완은 비관의 근거가 되지 못합니다.
- “지금 이해되는 대상은 LLM에 비해 너무 원시적”
- LLM을 바로 설명하려는 것이 아닙니다. 당장의 희망은 딥러닝의 기본 구성요소 를 이해함으로써, 전체 모델을 설명하지 않고도 유용한 지식을 얻는 것입니다.
- 이미 Empirical Scaling Laws, Hyperparameter Scaling 처방, NTK 기반 Data Attribution, 이론적으로 동기화된 Optimizer 등에서 일어나고 있는 일입니다.
- 원자론이 모든 과학의 토대가 되고, 전자기학이 수많은 응용 분야를 가능하게 했듯, 기본 객체에 대한 이론은 응용 분야(Mechanistic Interpretability 포함)의 도구가 됩니다.
- “중요한 건 모델의 고수준 행동. 미시 이론은 그걸 못 본다”
- 딥러닝은 물리학·생물학·심리학 수준 모두에서 연구할 수 있습니다.
- 학습 역학은 물리학, Mechanistic Interpretability는 생물학, 모델의 능력·목표를 다루는 Model Psychology는 심리학에 해당합니다.
- 모든 수준이 필요하며, 학습 역학은 이들 사이의 가장 미시적 층을 담당합니다.
- “필요한 건 딥러닝 이론이 아니라 데이터 이론이다”
- 둘 다 필요합니다. 데이터 구조 이론과, 매개변수화된 모델이 그 구조를 어떻게 학습하는지에 대한 이론 모두가 학습 역학의 일부입니다.
- “AI가 우리보다 먼저 딥러닝을 이해할 것”
- 이론은 이미 유용하며 발전할수록 더 유용해지므로 단기 영향이 큽니다.
- AI 단독으로 딥러닝 이론을 “해결”할 가능성은 낮고, 과학자와 AI의 협업이 더 현실적입니다.
- AI 안전 측면에서도, 인간이 해석 가능한 이론은 AI 시스템을 감독하기 위한 발판이 됩니다.
Summary
- 딥러닝에 대한 과학적 이론은 다음 다섯 가지 흐름을 통해 뚜렷해지고 있습니다.
- Solvable Settings ㅣ Deep Linear Networks와 NTK가 대표 사례
- Insightful Limits ㅣ Infinite Width의 Lazy/Rich 이분법과 이산화 가설
- Simple Empirical Laws ㅣ Scaling Laws, Edge of Stability, Neural Feature Ansatz
- Hyperparameter Theories ㅣ µP와 Hyperparameter Transfer
- Universal Phenomena ㅣ 아키텍처·데이터·표현의 보편성
- 이 과학은 학습 역학(Learning Mechanics) 이라는 이름으로 통합될 수 있으며, 고전역학·연속체·통계·양자역학과 구조적 평행을 공유합니다.
- 학습 역학은 Fundamental · Mathematical · Predictive · Comprehensive · Intuitive · Useful · Humble 의 일곱 요건을 지향합니다.
- 통계적·정보이론적·물리학적·신경과학적 관점과 상보적이며, Mechanistic Interpretability와는 물리학-생물학의 분업 관계를 이룹니다.
- Scaling Law 지수 예측, 하이퍼파라미터 제거, Feature의 수식적 정의, 표현 보편성의 메트릭 등 열 가지 방향이 앞으로의 과제로 남아 있습니다.
References
Guth, Florentin. “Science plays the long game.” Perspectives on the science of deep learning (2026). ↩︎
There Will Be a Scientific Theory of Deep Learning. Jamie Simon, Daniel Kunin, Alexander Atanasov, Enric Boix-Adserà, Blake Bordelon, Jeremy Cohen, Nikhil Ghosh, Florentin Guth, Arthur Jacot, Mason Kamb, Dhruva Karkada, Eric J. Michaud, Berkan Ottlik, Joseph Turnbull, et al. (2026). ↩︎ ↩︎2 ↩︎3 ↩︎4 ↩︎5 ↩︎6 ↩︎7
Simon, Jamie. “The scientific method in two steps.” Perspectives on the science of deep learning (2026). ↩︎
Karkada, Dhruva. “Towards an atlas of deep learning.” Perspectives on the science of deep learning (2026). ↩︎
Saxe, Andrew M., James L. McClelland, and Surya Ganguli. “Exact solutions to the nonlinear dynamics of learning in deep linear neural networks.” arXiv preprint arXiv:1312.6120 (2013). ↩︎
Saxe, Andrew M., et al. “A mathematical theory of semantic development in deep neural networks.” Proceedings of the National Academy of Sciences 116.23 (2019): 11537-11546. ↩︎
Rhee, Mark, Dhruva Karkada, and Jamie Simon. “Deep linear networks are a surprisingly useful toy model of weight-space dynamics.” Perspectives on the science of deep learning (2026). ↩︎
Jacot, Arthur, Franck Gabriel, and Clément Hongler. “Neural tangent kernel: convergence and generalization in neural networks.” Advances in Neural Information Processing Systems 31 (2018). ↩︎ ↩︎2
Chizat, Lénaïc, Edouard Oyallon, and Francis Bach. “On lazy training in differentiable programming.” Advances in Neural Information Processing Systems 32 (2019). ↩︎
Kaplan, Jared, et al. “Scaling laws for neural language models.” arXiv preprint arXiv:2001.08361 (2020). ↩︎ ↩︎2
Michaud, Eric J. “On neural scaling and the quanta hypothesis.” Perspectives on the science of deep learning (2026). Michaud, Liu, Girit, Tegmark. “The quantization model of neural scaling.” NeurIPS (2023). ↩︎
Cohen, Jeremy M., et al. “Gradient descent on neural networks typically occurs at the edge of stability.” International Conference on Learning Representations (2021). ↩︎ ↩︎2
Radhakrishnan, Adityanarayanan, et al. “Mechanism for feature learning in neural networks and backpropagation-free machine learning models.” Science 383.6690 (2024): 1461-1467. ↩︎
Yang, Greg, and Edward J. Hu. “Tensor programs IV: Feature learning in infinite-width neural networks.” International Conference on Machine Learning (2021). ↩︎
Yang, Greg, et al. “Tensor programs V: Tuning large neural networks via zero-shot hyperparameter transfer.” Advances in Neural Information Processing Systems (2022). ↩︎ ↩︎2