기계번역 톺아보기 (1) | 통계 모델과 Transformer
🔤 Noisy Channel부터 Transformer까지, 통계 기계번역과 신경망 기계번역의 전반을 정리합니다.
KEYWORDS
통계 기계번역, SMT, Noisy Channel, IBM 모델, EM 알고리즘, 로그선형 모형, BLEU, 신경망 기계번역, NMT, Encoder-Decoder, Attention, Transformer, Self-Attention, Positional Encoding, BPE, SentencePiece
Introduction
- 번역을 확률 모델로 수행하는 통계 기계번역(Statistical Machine Translation, SMT)은 1990년대 초반에 체계화되었습니다.
- 이후 신경망 기계번역(Neural Machine Translation, NMT)으로 대체되었지만, 두 계열의 모델은 지금의 LLM 번역에도 반복적으로 등장합니다.
- 본 글은 LLM 이전의 기계번역 수식 전반을 정리합니다.
잡음 채널 모델 Noisy Channel Model
- SMT는 번역을 탐색 문제로 세우는 데서 출발합니다.
- 원문 \(f = f_1^J\) 가 주어졌을 때 목표 문장 \(e = e_1^I\) 를 다음과 같이 계산합니다.
- 분모의 \(P(f)\) 는 \(e\) 와 무관하기 때문에 \(\arg\max\) 안에서 사라집니다. 남은 두 항은 역할이 다릅니다.
| 항 | 이름 | 담당 | 추정 데이터 |
|---|---|---|---|
| \(P(f \mid e)\) | 번역 모델 (Translation Model) | 충실성, 즉 원문의 내용이 옮겨졌는가 | 병렬 코퍼스 |
| \(P(e)\) | 언어 모델 (Language Model) | 유창성, 즉 목표 언어로 자연스러운가 | 목표 언어 단일어 코퍼스 |
방향이 뒤집혀 있는 이유
- 이 모델의 핵심은 방향이 뒤집혀 있다는 점입니다.
- 원문을 \(f\), 번역 결과를 \(e\) 라고 두면, \(e \to f\) 방향의 번역 모델로 \(f \to e\) 번역을 수행합니다.
- 이렇게 하는 이유는 언어 모델이 유창성을 따로 담당할 수 있게 하기 위함입니다.
- \(P(e \mid f)\) 를 직접 모형화하면 목표 언어의 문법성을 병렬 데이터만으로 학습해야 하는데, 단일어 데이터는 병렬 데이터보다 많습니다.
- 두 모델을 따로 학습해서 디코딩에서 결합하는 구조는 신경망 디코딩의 Shallow Fusion, 검색 증강 번역(kNN-MT)의 분포 보간, 그리고 RLHF/DPO에서 참조 정책에서 멀어지지 않도록 KL 제약을 거는 구성에서 반복적으로 등장합니다.
단어 정렬과 잠재변수 모형 Word Alignment
- 번역 모델 \(P(f \mid e)\) 를 직접 계산할 수는 없습니다.
- 우리에게 있는 것은 문장 Pair뿐이고, 어느 단어가 어느 단어에 대응하는지는 관측되지 않습니다. 그 숨은 대응을 잠재변수 \(a\) 로 둡니다.
- \(a_j = i\) 는 원문의 \(j\) 번째 단어가 목표 문장의 \(i\) 번째 단어에서 생성되었다는 뜻입니다.
- \(a_j = 0\) 은 대응이 없다는 뜻이며, 이를 NULL 토큰이라고 부릅니다.
- 잠재변수를 도입하면 번역 모델이 다음과 같이 전개됩니다.
- 가능한 모든 정렬 \(a\) 에 대해 주변화(Marginalization)해서 합산합니다.
- 모든 정렬을 열거하면 조합이 폭발하므로, \(P(f, a \mid e)\) 에 어떤 가정을 두느냐가 모델 설계의 핵심이 됩니다.
단어 정렬의 비대칭성
- 정렬은 비대칭적입니다.
- \(e \to f\) 방향과 \(f \to e\) 방향을 각각 학습하면 서로 다른 정렬이 산출됩니다.
- 두 방향 정렬의 교집합은 정밀도가 높고, 합집합은 재현율이 높습니다.
- 그래서 교집합에서 출발해 합집합 쪽으로 이웃을 조금씩 붙여 가는 grow-diag-final 같은 대칭화 휴리스틱(Symmetrization Heuristic)이 표준 절차로 쓰입니다.
IBM 모델 1부터 5까지 IBM Models
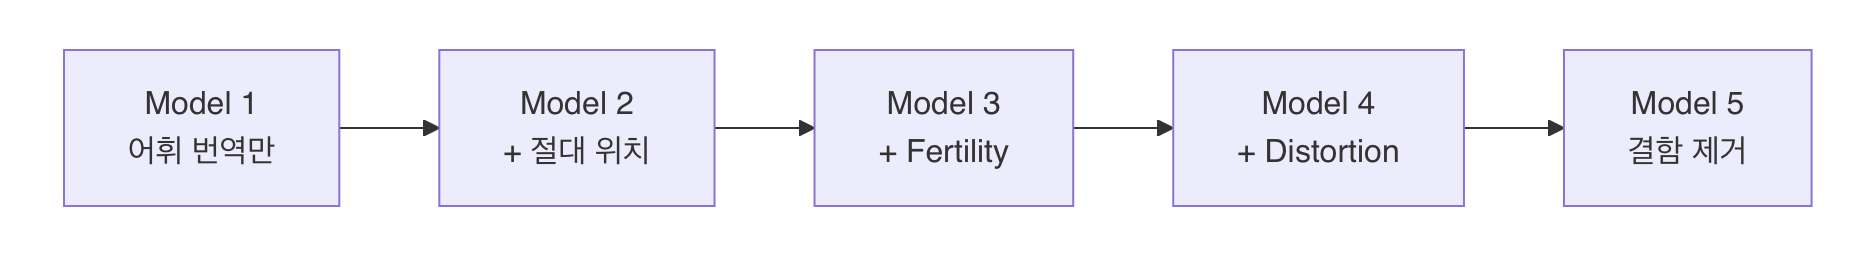
- IBM 모델 1부터 5는 \(P(f, a \mid e)\) 에 두는 가정을 단계적으로 완화하는 다섯 모델의 집합입니다.
- 각 모델이 새로 도입하는 가정이 다음 모델의 초기값으로 전달됩니다.
| 모델 | 추가되는 가정 | 정렬 확률 |
|---|---|---|
| 1 | 어휘 번역만 | 균등, \(P(a) = (I+1)^{-J}\) |
| 2 | 절대 위치 | \(P(a_j = i \mid j, I, J)\) |
| 3 | 다산성 (Fertility) | 목표 단어 하나가 원문 단어 몇 개를 생성하는가 |
| 4 | 상대 위치 왜곡 (Distortion) | 앞 단어 위치에 대한 상대 이동 |
| 5 | 결함 제거 | 모델 3과 4가 확률을 잃던 조건을 수정 |
모델 1은 어휘 번역 확률 \(t(f_j \mid e_i)\) 만 사용하며, 정렬은 균등 분포로 가정합니다. 어느 위치가 어느 위치에 정렬되는지는 모델링하지 않습니다.모델 2는 정렬에 위치 정보를 추가합니다. 원문 \(j\) 번째 단어가 목표 \(i\) 번째 단어에 정렬될 확률 \(P(a_j = i \mid j, I, J)\) 를 도입합니다.모델 3,4,5는 더 세밀한 현상을 다룹니다. 다산성(한 목표 단어가 여러 원문 단어를 생성할 수 있는 성질)과 왜곡(단어가 원래 자리에서 얼마나 이동했는가)을 명시적으로 모델링합니다.
 IBM 모델 1부터 5는 가정을 단계적으로 완화하는 다섯 모델의 집합
모델 1부터 순서대로 학습하는 이유
- 모델 1의 우도 함수는 볼록 함수(Convex Function) 입니다.
- 지역 최적해가 존재하지 않으므로 EM 알고리즘이 어느 초기값에서 출발해도 전역 최적해로 수렴합니다.
- 모델 2 이상은 볼록이 아니라서 좋은 초기값이 필요합니다.
- 그래서 모델 1을 먼저 학습해서 어휘 번역 확률 \(t\) 를 얻고, 그 값을 모델 2의 초기값으로 전달합니다.
- 모델 2가 수렴하면 다시 모델 3의 초기값으로 쓰고, 같은 방식으로 모델 5까지 이어 갑니다.
- 모델 1의 볼록성이라는 수학적 성질이 전체 학습 파이프라인의 순서를 결정합니다.
모델 1의 EM 유도 EM for Model 1
- IBM 모델 1의 EM 유도는 잠재변수가 있는 생성 모형의 전형적인 사례입니다.
- 어휘 번역 확률 \(t(f \mid e)\) 를 단계별로 추정하는 과정을 유도하겠습니다.
1. 우도의 정리
- 모델 1의 완전 데이터 우도는 다음과 같이 쓸 수 있습니다.
- 여기서 \(\epsilon\) 은 길이 분포의 상수이고, \((I+1)^{J}\) 는 균등 정렬 가정에서 유도되는 정규화 상수입니다.
- 정렬 \(a\) 를 주변화하면 다음을 얻습니다.
- 합과 곱의 순서가 교환된다는 점이 중요합니다.
- 원래는 모든 가능한 정렬에 대해 곱을 합산해야 하지만, 모델 1의 균등 정렬 가정 덕분에 각 위치별로 독립적으로 합산할 수 있습니다.
- 이 성질이 모델 1을 볼록으로 만드는 수학적 근거입니다.
2. E 단계와 M 단계
- EM 알고리즘은 두 단계를 번갈아 수행합니다.
- E 단계: 현재 \(t\) 로 각 단어 쌍의 기대 정렬 횟수를 계산합니다.
- M 단계: 그 기대 횟수를 사용해 \(t\) 를 다시 정규화합니다.
- 문장 쌍 \((f^{(s)}, e^{(s)})\) 에서 단어 \(f\) 가 단어 \(e\) 로부터 생성되는 기대 횟수는 다음과 같이 쓸 수 있습니다.
- 식의 의미를 풀어 보면 다음과 같습니다.
- \(\delta(f, f_j)\) 는 \(f_j\) 가 \(f\) 와 같을 때만 1을 반환하는 지시 함수(Indicator Function)입니다.
- 분자 \(t(f_j \mid e)\) 는 특정 정렬이 선택될 확률의 분자 부분입니다.
- 분모 \(\sum_{i} t(f_j \mid e_i)\) 는 가능한 모든 정렬에 대한 정규화 항입니다.
- 분수 전체는 \(f_j\) 가 어느 목표 단어에서 왔는지에 대한 사후 분포에서 \(e\) 가 선택될 확률에 해당합니다.
- M 단계에서는 이 기대 횟수를 모아 \(t\) 를 갱신합니다.
- 분자는 \(e\) 가 \(f\) 를 생성한 기대 횟수의 전체 합이고, 분모는 \(e\) 가 어떤 단어든 생성한 기대 횟수의 합입니다.
- 두 값을 나누면 비율로 다시 정규화된 분포가 됩니다.
3. 수렴성
- 모델 1은 볼록이기 때문에 어느 초기값에서 출발해도 같은 전역 최적해로 수렴합니다.
- EM이 각 반복에서 우도를 비감소적으로 올리는 성질이 보장되므로, 지역 최적해에 갇히지 않습니다.
- 모델 2 이상은 볼록성이 깨지므로 단계적 초기화가 표준 절차가 됩니다.
구문 기반 번역과 로그선형 모형 Phrase-Based Translation
- 모델 1부터 5는 단어 단위 정렬만 다룹니다.
- 그런데 번역에서는
take off같이 여러 단어가 묶여야 의미가 성립하는 구문이 많고, 어순이 크게 달라지는 언어쌍도 많습니다. - 이 한계를 넘기 위해 구문 기반 번역(Phrase-Based Translation) 이 도입됩니다.
- 그런데 번역에서는
일관된 구문 쌍 추출
- 단어 정렬에서 일관된 구문 쌍(Consistent Phrase Pair) 을 모두 추출합니다. 일관성 조건은 다음과 같습니다.
- 구문 안의 단어가 구문 밖으로 정렬되지 않아야 합니다.
- 반대 방향에서도 마찬가지로, 목표 구문 안의 단어가 원문 구문 밖으로 정렬되면 안 됩니다.
- 추출된 구문 쌍이 번역의 기본 단위가 됩니다. 번역은 다음 세 단계로 진행됩니다.
- 원문을 구문으로 분할합니다.
- 각 구문을 목표 언어 구문으로 번역합니다.
- 목표 구문들의 순서를 재배열합니다.
로그선형 모형
- 잡음 채널의 두 항(\(P(f \mid e)\) 와 \(P(e)\))만으로는 구문 기반 번역을 다루기에 부족합니다.
- 여러 Feature을 동시에 고려해야 합니다.
- 각 자질에 가중치를 곱해 지수 함수로 묶는 로그선형 모형(Log-linear Model) 을 사용합니다.
- \(Z(f) = \sum_{e'} \exp(\sum_m \lambda_m h_m(e', f))\) 는 분배 함수(Partition Function)로, \(f\) 가 주어지면 상수가 되기 때문에 \(\arg\max\) 에서 사라집니다.
- 자질 함수 \(h_m\) 에는 다음과 같은 요소가 포함됩니다.
| Feature | 내용 |
|---|---|
| \(\phi(f \mid e), \phi(e \mid f)\) | 구문 번역 확률 양방향 |
| \(\text{lex}(f \mid e), \text{lex}(e \mid f)\) | 구문 내부 단어 정렬로 계산한 어휘 가중 |
| \(P_{\text{LM}}(e)\) | 언어 모델 |
| \(\exp(\lvert e \rvert)\) | 단어 벌점, 출력 길이 조절 |
| \(d(\cdot)\) | 재배열 비용 |
| 구문 개수 | 분할의 조밀도 |
MERT: 지표에 직접 최적화
- 로그선형 가중치 \(\lambda\) 를 BLEU 같은 자동 지표에 직접 맞추는 방법이 최소 오류율 학습(Minimum Error Rate Training, MERT) 입니다.
- 목적 함수가 조각별 상수(Piecewise Constant) 입니다.
- 가중치가 조금 바뀌어도 \(\arg\max\) 로 뽑히는 후보가 바뀔 때까지는 BLEU가 변하지 않기 때문에, 미분이 정의되지 않는 영역이 존재합니다.
- MERT는 한 좌표씩 선을 따라가며 후보 순위가 바뀌는 지점을 모두 찾고, 그 구간의 지표를 각각 계산하는 선 탐색(Line Search) 을 사용합니다.
- 지표에 직접 최적화하는 접근은 이후 신경망 시대의 순차 수준 학습(Minimum Risk Training), 그리고 LLM 선호 학습(RLHF/DPO)의 보상 함수에서 재사용됩니다.
디코딩과 cube pruning
- 로그선형 모형에서 번역을 생성하는 과정은 스택 기반 beam search 로 처리합니다.
- 원문 단어를 몇 개 덮었는지(커버리지)로 스택을 나눕니다.
- 각 스택에서 점수 상위 가설만 남깁니다.
가설 재결합(같은 언어 모델 상태와 커버리지면 하나로 합침)과 미래 비용 추정(Future Cost Estimation)이 함께 적용됩니다.
- 계층적 구문 모형(Hierarchical Phrase-Based Translation, Hiero) 은 구문에 비종단 기호를 넣어 동기 문맥자유문법(Synchronous Context-Free Grammar, SCFG)으로 확장합니다.
- 예를 들어 다음 규칙은 장거리 재배열을 담을 수 있습니다.
1
X → ⟨ne X pas, do not X⟩
- 디코딩은 CKY 파싱이 되고, 언어 모델 상태가 붙어 탐색 공간이 커지므로 각 셀에서 유망한 조합만 보는 cube pruning 을 적용합니다.
BLEU 자동 평가 BLEU Metric
- 자동 지표는 모형을 평가하는 도구지만, 기계번역에서는 그 도구가 모델링 방향에도 영향을 줍니다.
- MERT가 BLEU를 직접 최적화하는 지점부터 그렇습니다.
1. n-gram 정밀도
- BLEU는 n-gram 정밀도의 기하평균에 길이 벌점을 곱한 지표입니다.
- 분모는 후보 번역에 나타난 n-gram의 전체 개수이고, 분자는 각 n-gram이 참조에서 등장한 횟수를 상한으로 잘라낸 절단(clipping) 횟수의 합입니다.
- 절단 처리가 없으면 흔한 단어를 반복해서 정밀도를 인위적으로 올릴 수 있습니다.
- 예를 들어 참조에
the가 2번 나오는데 후보에the the the the가 있다면, 절단 없이는 4/4, 절단으로는 2/4가 됩니다.
- 예를 들어 참조에
2. 기하평균과 길이 벌점
- 전체 BLEU는 n-gram 정밀도 \(p_1, p_2, p_3, p_4\) 를 기하평균으로 묶고 길이 벌점(Brevity Penalty, BP) 을 곱합니다.
- \(c\) 는 후보 전체 길이, \(r\) 은 참조 전체 길이입니다. 가중치 \(w_n\) 은 보통 균등하게 \(1/N\) 을 사용합니다.
- 정밀도만 사용하고 재현율은 사용하지 않는 대신, 길이 벌점으로 짧은 번역이 과점을 받는 것을 억제합니다.
3. 기하평균의 성질
- 기하평균이기 때문에 어느 한 \(n\) 에서 \(p_n = 0\) 이면 전체가 0 이 됩니다. \(\log 0 = -\infty\) 가 지수를 통해 0으로 수렴하기 때문입니다.
- 문장 단위로 BLEU를 사용할 때는 평활(smoothing)이 필요한 이유이기도 합니다. 그래서 BLEU는 본래 코퍼스 수준 지표로 설계되었습니다.
다른 지표와의 관계
- chrF 는 문자 단위 n-gram의 F-score입니다.
- 단어 분절에 의존하지 않기 때문에 형태가 복잡한 교착어에서 BLEU보다 덜 불리합니다.
- TER 은 후보를 참조로 바꾸는 데 필요한 최소 편집 횟수를 참조 길이로 나눈 값입니다.
- 삽입, 삭제, 치환에 더해 구문 이동(shift)을 한 번의 편집으로 계산합니다.
- 세 지표 모두 문자열 겹침 기반이라는 공통된 한계를 가집니다.
- 바꿔 쓴 표현(Paraphrase)을 벌한다는 문제가 가장 중요합니다. 뜻이 같아도 참조와 글자가 다르면 점수가 낮아집니다.
- 이 한계가 (2)편에서 다룰 뉴럴 평가지표(BLEURT, COMET 등)의 등장 배경이 됩니다.
신경망으로의 전환 Transition to Neural MT
- SMT는 번역을 두 개(또는 여러 개)의 모형으로 분해하고, 각 모형에 가정을 명시적으로 두는 접근이었습니다.
- 신경망 번역은 번역을 하나의 미분 가능한 조건부 분포로 두고, 가정은 모델 구조와 학습 데이터에 녹여 둡니다.
- 목표 문장을 왼쪽에서 오른쪽으로 하나씩 생성하는 자기회귀 분해(Autoregressive Factorization) 가 출발점입니다.
- SMT와 세 가지 지점에서 결정적으로 달라집니다.
- 첫째, 잡음 채널을 사용하지 않고 \(P(e \mid f)\) 를 직접 모형화합니다.
- 둘째, 구문이라는 중간 단위가 사라집니다. 번역의 단위는 토큰이고, 분할과 재배열이라는 명시적 단계가 모델 내부로 흡수됩니다.
- 셋째, 사람이 설계한 자질이 모두 학습된 벡터 표현으로 대체됩니다.
Encoder-Decoder 구조 Seq2Seq Architecture
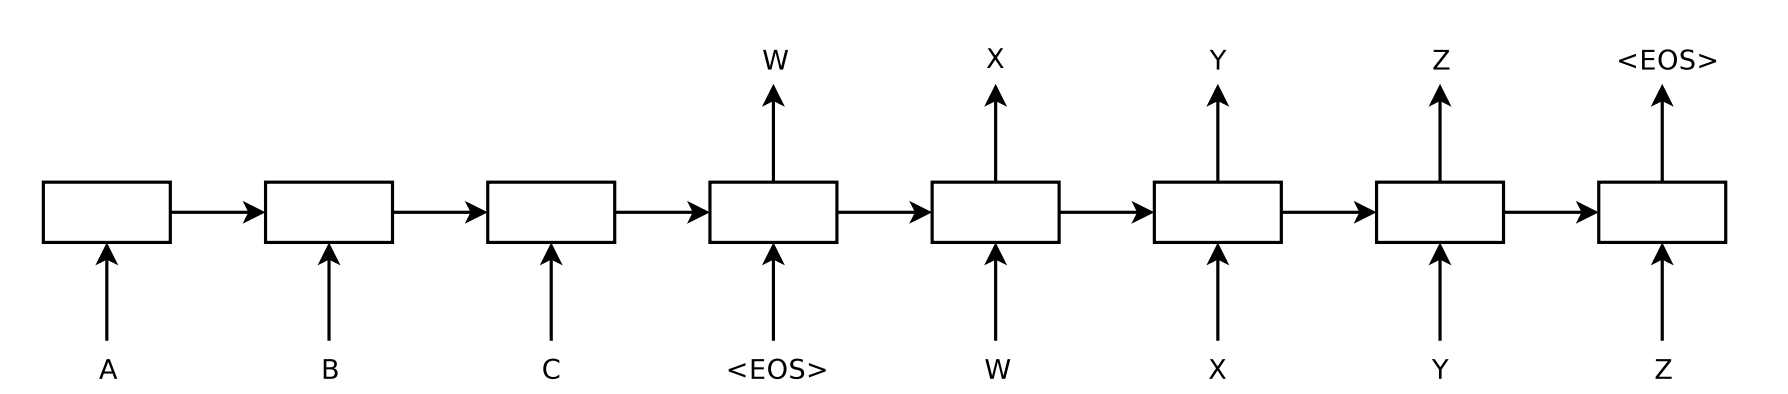
- 초기 신경망 번역 구조는 Encoder가 원문을 벡터 하나로 압축하고, Decoder가 그 벡터를 조건으로 목표 문장을 생성합니다.
- Encoder는 원문 토큰 \(x_1, x_2, \dots, x_J\) 를 순차적으로 읽어서 은닉 상태 \(h_j\) 를 갱신합니다.
- 마지막 상태 \(h_J\) 를 문맥 벡터 \(c\) 로 삼습니다.
- Decoder는 매 시점 \(t\) 마다 이전 은닉 상태 \(s_{t-1}\), 이전 출력 토큰 \(y_{t-1}\), 그리고 고정된 문맥 벡터 \(c\) 를 입력으로 받아 새 은닉 상태 \(s_t\) 를 산출합니다.
- 마지막으로 Softmax로 어휘 분포를 얻습니다.
 RNN Encoder-Decoder 구조 1
고정 길이 문맥 벡터의 한계
- 이 구조에는 구조적인 한계가 있습니다. 문맥 벡터 \(c\) 가 고정 길이라서, 원문 길이에 상관없이 같은 차원의 벡터 하나로 모든 정보를 압축해야 합니다.
- 문장이 길어지면 앞쪽 정보가 벡터 안에서 희석되고, 실제로 입력 길이가 늘어날수록 번역 성능이 떨어지는 곡선이 관측됩니다.
- 순환 구조의 기울기 소실은 LSTM과 GRU의 게이트로 완화할 수 있지만, 고정 길이 병목은 LSTM으로도 해결되지 않습니다.
- 이 병목이 다음 절의 Attention을 도입하는 직접적 동기가 됩니다.
Bahdanau Attention Attention Mechanism
- 고정 길이 벡터 한계를 해소하는 방법은 문맥 벡터를 매 생성 시점마다 다시 계산하는 것입니다.
- Bahdanau et al. (2015)이 이 아이디어를 체계화했습니다.
문맥 벡터의 동적 계산
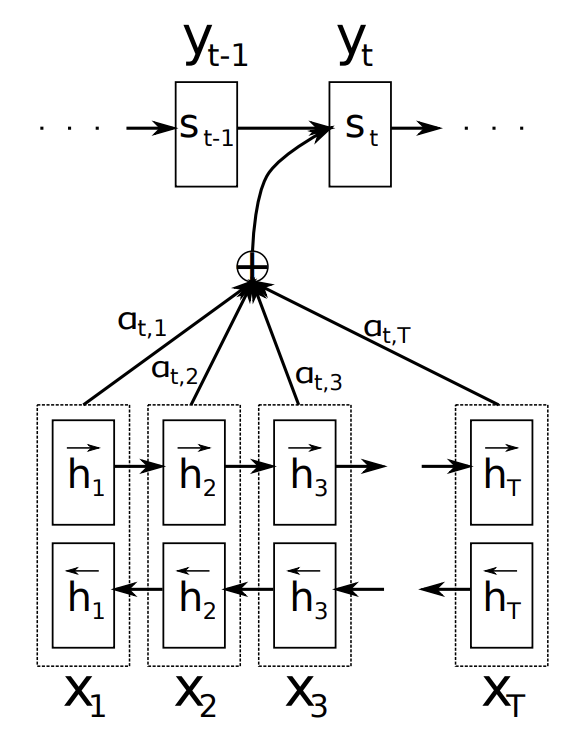
- Attention 구조에서는 Decoder가 매 시점 \(t\) 에 원문의 모든 은닉 상태 \(h_1, \dots, h_J\) 를 보고 가중합을 계산합니다.
- 가중치는 현재 Decoder 상태와의 부합도로 정합니다.
- 각 식의 역할은 다음과 같습니다.
- \(e_{tj}\) 는 Decoder가 시점 \(t\) 에서 원문 \(j\) 번째 위치에 얼마나 주목할지의 정렬 점수(Alignment Score) 입니다.
- 함수 \(a\) 는 Decoder 상태와 Encoder 상태를 입력받는 작은 신경망입니다.
- \(\alpha_{tj}\) 는 그 점수를 Softmax로 정규화해서 확률 분포로 만든 가중치입니다.
- 모든 \(j\) 에 대해 \(\sum_j \alpha_{tj} = 1\) 이 성립합니다.
- \(c_t\) 는 가중치로 Encoder 상태를 섞어 만든 시점별 문맥 벡터입니다.
- \(e_{tj}\) 는 Decoder가 시점 \(t\) 에서 원문 \(j\) 번째 위치에 얼마나 주목할지의 정렬 점수(Alignment Score) 입니다.
- 매 시점마다 \(c_t\) 가 새로 계산되므로, 긴 문장에서도 Decoder가 원문의 적절한 위치를 선택적으로 참조할 수 있습니다.
 Bahdanau Attention 2
점수 함수의 변형
- 정렬 점수 함수 \(a(\cdot)\) 를 어떻게 두는가에 따라 변형이 나뉩니다.
| 이름 | 형태 | 특징 |
|---|---|---|
| 가산(Additive) | \(v^{\top}\tanh(W_1 s + W_2 h)\) | 파라미터가 존재하고 차원이 달라도 됨 |
| 곱셈(Dot) | \(s^{\top} h\) | 파라미터가 없고 빠름 |
| 일반(General) | \(s^{\top} W h\) | 곱셈에 사영을 추가 |
| 축척 내적(Scaled Dot) | \(s^{\top} h / \sqrt{d}\) | 차원이 커질 때 Softmax 포화를 방지 |
- 원논문은 가산 형태를 사용했습니다. Luong et al. (2015)이 곱셈과 일반 형태를 제시하며 비교했고, 축척 내적은 Transformer에서 다시 등장합니다.
정렬의 연속 완화
- Bahdanau Attention은 수학적으로 IBM 모델의 단어 정렬 \(a_j\) 를 연속 분포로 완화한 것과 같은 구조를 가집니다.
- IBM 모델에서 \(a_j\) 는 하나의 위치를 고르는 이산 변수였고, 주변화에 모든 가능한 정렬을 합산해야 해서 EM이 필요했습니다.
- Attention에서는 \(\alpha_{tj}\) 가 모든 위치에 대한 확률 분포가 됩니다.
- 미분 가능하고 역전파로 학습되므로, 별도 정렬 도구를 요구하지 않습니다.
- Attention 가중치를 정렬로 해석하는 것은 근사이며, 특히 multi-head 환경에서는 이 해석이 더 느슨해집니다.
Transformer Attention Is All You Need
- Transformer는 순환 구조를 완전히 제거하고 Attention만으로 모형을 구성합니다.
- 시점 간 의존이 사라지므로 한 문장의 모든 위치를 병렬로 계산할 수 있고, 긴 시퀀스 학습이 훨씬 빨라집니다.
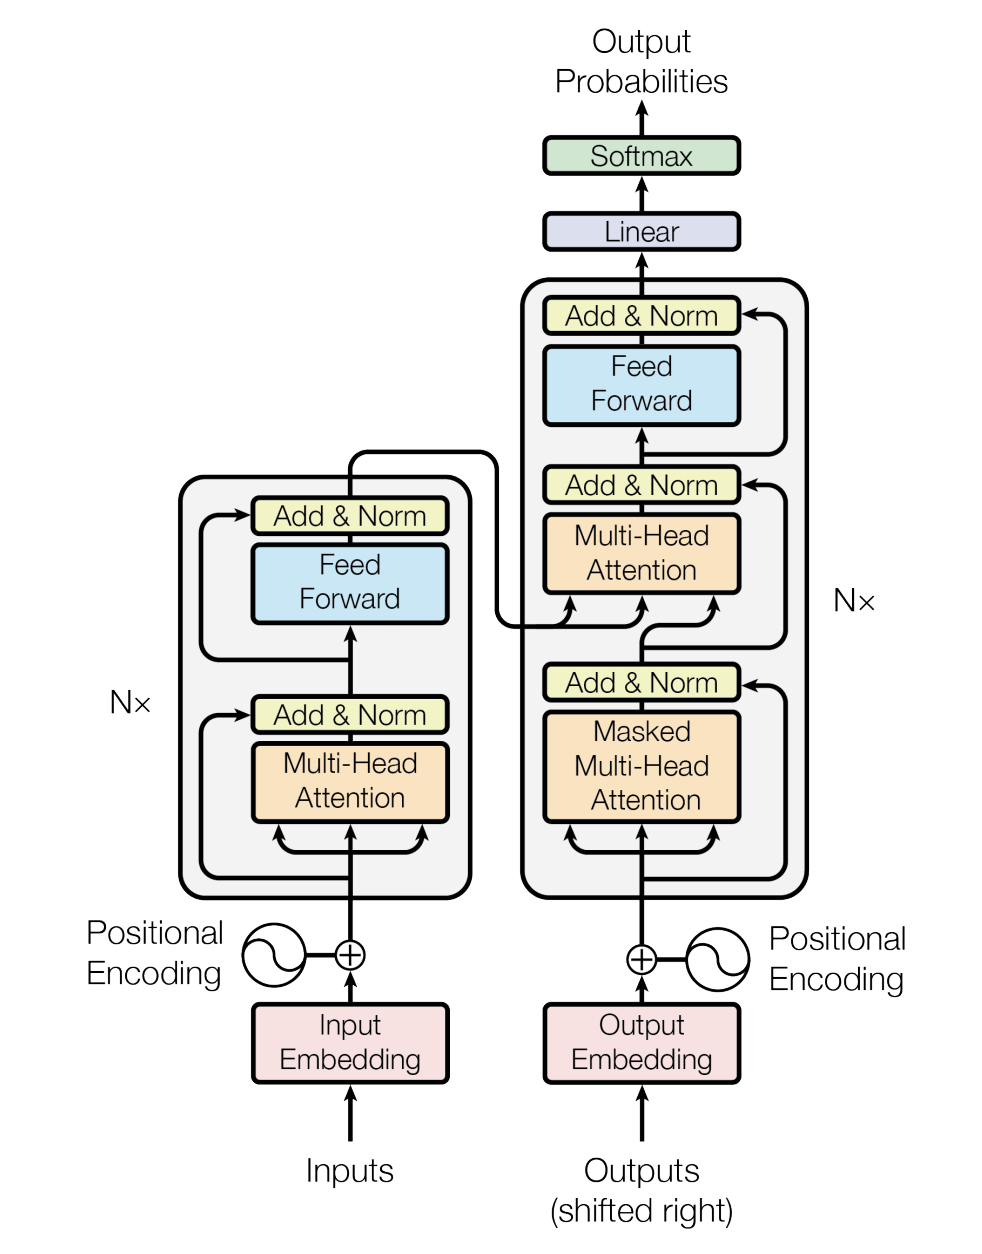 Transformer 전체 아키텍처 3
Scaled Dot-Product Attention
- Transformer의 기본 연산은 축척 내적 주의(Scaled Dot-Product Attention) 입니다.
- 질의 \(Q \in \mathbb{R}^{T \times d_k}\), 키 \(K \in \mathbb{R}^{S \times d_k}\), 값 \(V \in \mathbb{R}^{S \times d_v}\) 가 주어지면 다음과 같이 계산합니다.
- 식을 단계별로 분해하면 다음과 같습니다.
- \(QK^{\top} \in \mathbb{R}^{T \times S}\) 는 모든 질의와 모든 키 사이의 내적입니다.
- 각 행이 하나의 질의가 모든 키와 얼마나 유사한지를 담은 유사도 벡터가 됩니다.
- 이 유사도를 \(\sqrt{d_k}\) 로 나누고 Softmax로 정규화해 가중치 분포를 산출합니다.
- 그 가중치로 값 \(V\) 의 행들을 가중합해 최종 출력을 얻습니다.
- \(QK^{\top} \in \mathbb{R}^{T \times S}\) 는 모든 질의와 모든 키 사이의 내적입니다.
\(\sqrt{d_k}\) 스케일링의 유도
- Scaled Dot-Product의 스케일링 요인 \(\sqrt{d_k}\) 는 수학적으로 명확한 이유가 있습니다.
- 질의 벡터와 키 벡터의 각 성분이 서로 독립이고 평균 0, 분산 1이라고 가정합니다.
- 두 벡터의 내적은 다음과 같습니다.
- \(q_i k_i\) 의 평균은 \(\mathbb{E}[q_i]\mathbb{E}[k_i] = 0\) 이고 분산은 \(\text{Var}(q_i)\text{Var}(k_i) = 1\) 입니다.
- 서로 독립인 성분을 \(d_k\) 개 더하므로 분산이 \(d_k\) 로 커집니다.
- 분산이 커지면 내적 값의 범위가 넓어지고, Softmax에 넣었을 때 큰 값이 지배하면서 분포가 극단적으로 뾰족해집니다.
- 뾰족한 Softmax는 기울기가 거의 0인 영역이 많아서 학습이 멈춥니다.
- 표준편차 \(\sqrt{d_k}\) 로 나누면 분산이 다시 1로 돌아오고, Softmax가 안정적인 영역에서 작동합니다.
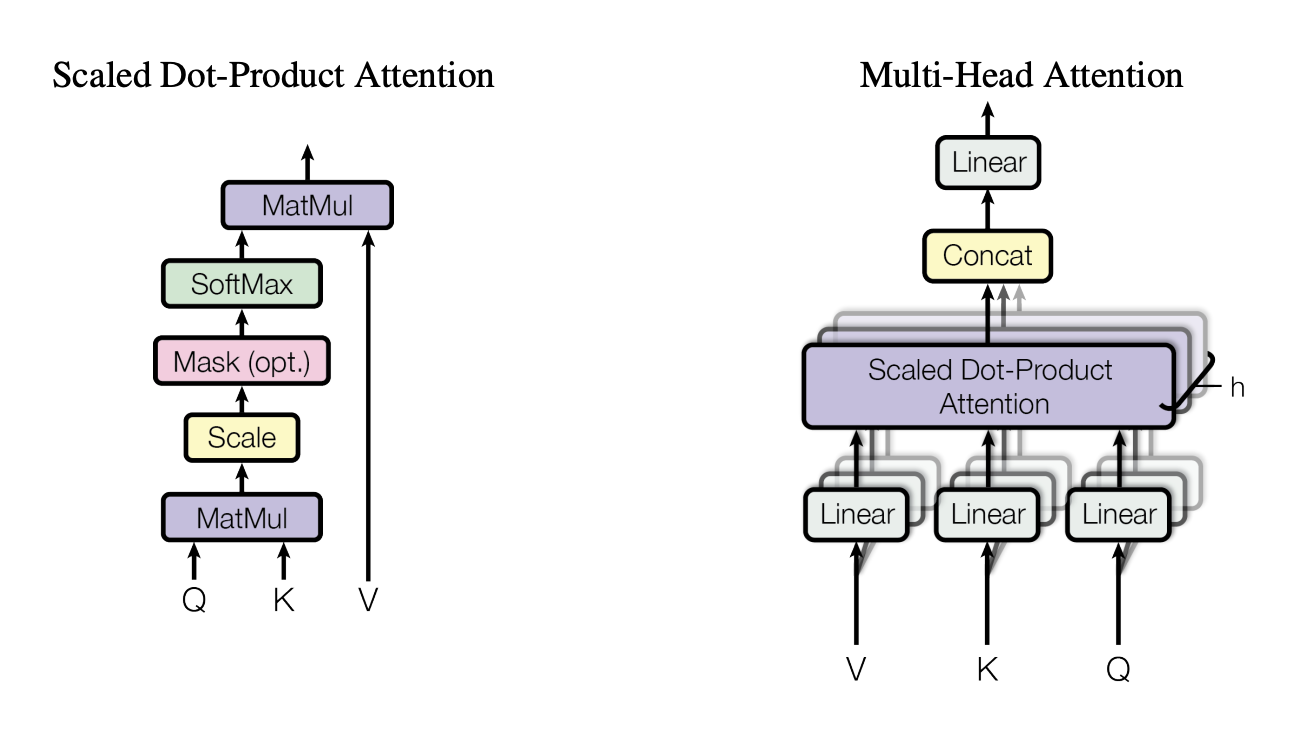 Scaled Dot-Product Attention (왼쪽) vs Multi-Head Attention (오른쪽) 3
Multi-Head Attention
- Transformer는 Attention을 여러 번 병렬로 계산해서 서로 다른 관계를 포착합니다.
- 이것이 Multi-Head Attention입니다.
- 각 헤드가 담당하는 사영 행렬의 차원은 다음과 같습니다.
- \[W_i^Q, W_i^K \in \mathbb{R}^{d_{\text{model}} \times d_k}\]
- \[W_i^V \in \mathbb{R}^{d_{\text{model}} \times d_v}\]
- \[W^O \in \mathbb{R}^{hd_v \times d_{\text{model}}}\]
- 보통 \(d_k = d_v = d_{\text{model}}/h\) 로 설정합니다.
- \(d_{\text{model}}\) 차원을 \(h\) 개의 작은 서브공간으로 쪼개고, 각 서브공간에서 독립적으로 Attention을 계산한 뒤 결과를 이어 붙이는 구성입니다.
- 실제로 헤드마다 다른 유형의 관계를 담당하는 경향이 관측됩니다.
- 어떤 헤드는 국소 인접 관계를, 다른 헤드는 구문 의존을, 또 다른 헤드는 위치 복사 패턴을 포착합니다.
세 가지 주의의 쓰임
- Transformer 안에서 Attention은 세 가지 서로 다른 역할로 사용됩니다.
| 위치 | \(Q\) 출처 | \(K, V\) 출처 | 마스킹 |
|---|---|---|---|
| Encoder 자기 주의 | Encoder 층 | 같은 층 | 패딩만 |
| Decoder 자기 주의 | Decoder 층 | 같은 층 | 인과 마스크(Causal Mask), 미래 차단 |
| 교차 주의(Cross-Attention) | Decoder 층 | Encoder 최종 층 | 패딩만 |
- Decoder 자기 주의의 인과 마스크가 자기회귀 생성을 가능하게 하는 핵심 장치입니다.
- 시점 \(t\) 에서 미래 시점 \(t' > t\) 의 토큰을 볼 수 없도록 Softmax 이전에 \(-\infty\) 로 가립니다.
Positional Encoding
- 순환 구조가 없기 때문에 순서 정보를 따로 주입해야 합니다.
- Transformer 원논문은 사인/코사인 함수로 위치를 부호화합니다.
- \(pos\) 는 위치, \(i\) 는 차원 인덱스입니다.
- 짝수 차원은 사인, 홀수 차원은 코사인을 쓰고, 파장은 \(10000^{2i/d}\) 로 기하적으로 배치됩니다.
- 저차원은 파장이 짧아 가까운 위치를 구분하고, 고차원은 파장이 길어 멀리 떨어진 위치까지 담습니다.
- 이 설계의 수학적 성질은 선형 변환으로 상대 위치를 표현할 수 있다는 점입니다.
- 두 위치 \(pos\) 와 \(pos + k\) 의 PE 값은 삼각함수 덧셈 정리로 선형 관계로 묶이기 때문에, Attention 내부에서 상대 위치 정보를 추출할 수 있습니다.
- 이후 상대 위치 표현(Shaw et al. 2018), 회전 위치 부호화(RoPE)가 제안되었고, RoPE는 LLaMA와 Qwen 계열의 사실상 표준이 되었습니다.
층 구성: 잔차 연결과 층 정규화
- 각 Attention 부분층과 FFN 부분층은 잔차 연결(Residual Connection) 과 층 정규화(Layer Normalization) 로 감싸져 있습니다.
- 원논문은 다음과 같은 후행 정규화(Post-LN) 를 사용했습니다.
- 이후 깊은 모형에서는 선행 정규화(Pre-LN) 가 학습을 더 안정시킨다는 것이 밝혀졌고, 지금은 Pre-LN이 사실상 표준입니다.
- 위치별 순방향망(Position-wise FFN)은 각 위치에 독립적으로 적용되는 2층 완전연결망입니다.
- 중간 차원 \(d_{\text{ff}}\) 는 보통 \(4 d_{\text{model}}\) 로 설정합니다.
RNN을 대체한 수학적 근거
- Transformer의 계산 복잡도를 RNN과 비교하면 다음과 같습니다.
- 자기 주의: \(O(n^2 d)\)
- 순환: \(O(n d^2)\)
- 문장 단위 번역에서는 \(n\) (시퀀스 길이)이 \(d\) (임베딩 차원)보다 작은 범위에서는 자기 주의가 유리합니다.
- 더 중요한 것은 경로 길이(Path Length) 입니다.
- RNN은 시점 \(t\) 와 시점 \(t'\) 사이에 \(\lvert t - t' \rvert\) 단계의 재귀가 끼지만, Self-Attention은 모든 쌍이 \(O(1)\) 단계로 연결됩니다.
- 짧은 경로가 장거리 의존을 더 쉽게 만들고, 병렬 계산이 학습 속도를 올리는 두 효과가 결합되어 Transformer가 RNN을 대체하게 됩니다.
서브워드 분절 Subword Tokenization
- 신경망 번역에는 모형 못지않게 어휘 설계가 중요합니다.
- 어휘를 단어로 두면 미등록어(Out-of-Vocabulary, OOV)를 다룰 수 없고, 문자로 두면 시퀀스가 너무 길어집니다.
- 서브워드 분절이 그 사이의 균형점입니다.
BPE 알고리즘
- BPE(Byte-Pair Encoding) 는 문자 단위에서 시작해 가장 빈번한 인접 쌍을 반복 병합하는 탐욕 알고리즘입니다.
- 병합 횟수가 어휘 크기를 결정합니다.
1
2
3
4
초기   l o w </w>   l o w e r </w>   n e w e s t </w>
병합1  (e, s) → es
병합2  (es, t) → est
...
- 자주 등장하는 접미사(
est,ing)나 어근은 하나의 토큰으로 묶이고, 희귀 단어는 여러 서브워드로 쪼개집니다.- 이 방식으로 어휘 크기를 통제하면서 OOV를 제거할 수 있습니다.
- 번역에서 BPE가 유용한 또 다른 이유는 원문과 목표 양쪽에 공유 가능하다는 점입니다.
- 두 언어의 어휘를 함께 학습하면 공통된 서브워드(고유명사, 숫자, 접사)가 자연스럽게 양쪽에 등장해서 복사가 쉬워집니다.
Unigram Language Model Tokenization
- Unigram 분절은 BPE와 다른 접근을 사용합니다.
- 분절 \(x = (x_1, \dots, x_M)\) 의 확률을 독립 곱으로 두는 생성 모형을 세웁니다.
- 여기서 \(S(X)\) 는 문자열 \(X\) 를 분절하는 가능한 모든 방법의 집합이고, 최적 분절은 Viterbi 알고리즘으로 찾습니다.
- 학습은 어휘 \(V\) 를 크게 시작해 우도 손실이 가장 작은 조각들을 반복 제거하는 방식으로 진행됩니다.
- 손실 함수는 다음과 같습니다.
- Unigram은 서브워드 정규화(Subword Regularization) 를 자연스럽게 지원합니다.
- 학습 때 분절을 확률적으로 샘플링해서 같은 문장의 여러 분절을 모형에 제시합니다.
- 정규화 효과가 있고 추론 시 분절 불일치에 강해집니다.
SentencePiece
- SentencePiece 는 BPE나 Unigram을 쓰는 토크나이저 라이브러리인데, 중요한 설계 결정이 있습니다.
- 공백을 특수 문자
▁로 바꿔 어휘에 포함시킵니다.
- 공백을 특수 문자
- 이 결정의 효과는 사전 토큰화(Pre-tokenization)를 제거할 수 있다는 것입니다.
- 공백 기준 분할이라는 전처리가 사라지므로, 중국어나 일본어처럼 공백이 없는 언어와 영어가 같은 파이프라인을 사용할 수 있습니다.
- 다국어 번역 모형에서 SentencePiece가 사실상 표준이 된 이유도 이 때문입니다. LLM 토크나이저 대부분도 SentencePiece 기반이거나 그 변형입니다.
Conclusion
- SMT는 번역을 두 모델의 결합으로 세웁니다.
- Noisy Channel은 충실성과 유창성을 분리해서 각각 다른 데이터로 학습하게 만들었고, IBM 모델은 단어 정렬을 잠재변수로 두고 EM으로 어휘 번역 확률을 추정했습니다.
- 구문 기반 번역과 로그선형 모형은 여러 자질을 결합하고 MERT로 BLEU에 직접 최적화합니다.
- BLEU는 n-gram 정밀도의 기하평균에 길이 벌점을 곱한 지표입니다.
- NMT는 번역을 하나의 미분 가능한 조건부 분포로 둡니다.
- Encoder-Decoder가 자기회귀 분해로 번역을 다시 세웠고, Bahdanau Attention이 고정 길이 문맥 벡터의 한계를 해소했으며, Transformer가 순환을 완전히 제거하고 Attention만으로 모델을 구성했습니다.
- 서브워드 분절은 어휘 설계의 표준으로 자리잡았습니다.
- (2)편에서는 LLM 시대의 기계번역을 다루겠습니다.
References
Sutskever, Ilya, Oriol Vinyals, and Quoc V. Le. “Sequence to Sequence Learning with Neural Networks.” NeurIPS (2014). ↩︎
Bahdanau, Dzmitry, Kyunghyun Cho, and Yoshua Bengio. “Neural Machine Translation by Jointly Learning to Align and Translate.” ICLR (2015). ↩︎
Vaswani, Ashish, et al. “Attention Is All You Need.” NeurIPS (2017). ↩︎ ↩︎2